“The prompt could not be submitted. The prompt contains sensitive words that violate Google's Generative AI Prohibited Use Policy. Try rephrasing the prompt. If you think this was an error, send feedback.” 这句英文报错是 Google 的内容政策拦截:你的提示(或随提示上传的图片)在提交阶段被安全过滤器判定为触碰《生成式 AI 使用限制政策》,模型没有开始生成。它和网络、地区、额度、余额、账号状态都没有关系,换网络、换 IP、充值或重新登录都不会改变结果。
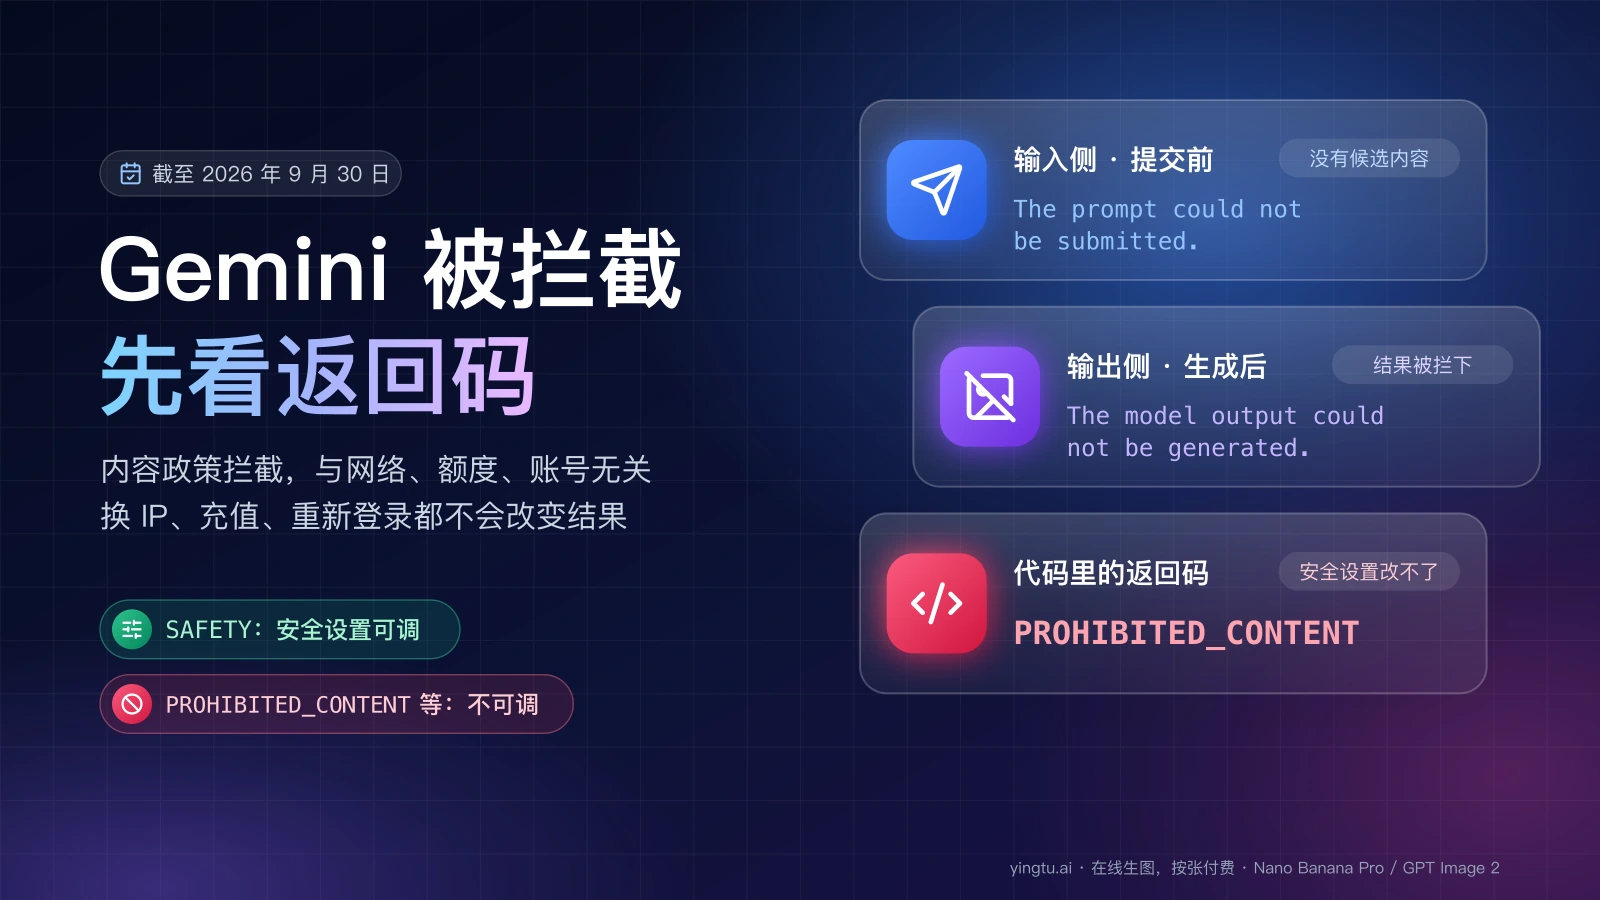
同一套拦截在不同位置有三种写法:输入被拦时是上面这句“The prompt could not be submitted…”;输出被拦时是“The model output could not be generated…”;在代码里则是 promptFeedback.blockReason 或 finishReason 取值 PROHIBITED_CONTENT。三种写法背后的判断逻辑相同,处理思路也相同:先弄清是输入侧还是输出侧被拦,再看返回码属于可调的 SAFETY 还是不可调的 PROHIBITED_CONTENT,然后定位触发点并把提示改写成你真正想要的合法结果。如果你的需求本身就在政策禁止范围内(成人内容、未成年人、真人私密或暴力场景、规避过滤器),那么拦截是正确的,下面的方法不适用,也不应该继续。
截至 2026 年 9 月 30 日,Gemini API 文档只把四类内容(骚扰、仇恨言论、色情、危险内容)列为可调阈值,其余“核心危害”写明“始终拦截,无法调整”;而 Gemini 2.5 和 3 系列不设阈值时,这四类的默认值就是 Off。所以你在这些模型上仍然看到拦截,几乎都是不可调那一层触发的,调安全设置不会有帮助。
The prompt could not be submitted:输入在提交前被拦
“The prompt could not be submitted. The prompt contains sensitive words that violate Google's Generative AI Prohibited Use Policy. Try rephrasing the prompt. If you think this was an error, send feedback.”
这句话表示输入侧拦截:过滤器在模型生成之前就拒绝了整条提示,没有任何候选内容返回。它出现在 Gemini 应用和 Google AI Studio 里(有的界面复制出来时,“Generative AI Prohibited Use Policy”和“send feedback”带着链接,分别指向政策页和 ai.google.dev/gemini-api/docs/troubleshooting),也会原样出现在基于 Gemini API 的第三方工具里,例如 AI Studio 反代、小说和角色聊天工具、编码智能体。
在代码里,同一句话作为 promptFeedback.blockReasonMessage 返回,旁边是 "blockReason": "PROHIBITED_CONTENT";用 google-genai SDK 时表现为 HTTP 400 invalid_request,消息以“Input blocked: The prompt could not be submitted.…”开头(2026 年 7 月 Google AI 开发者论坛的报告,见下文误报案例)。HTTP 400 在这里不代表参数写错,api-errors 文档把 400 归为 invalid_request / failed_precondition,内容拦截借用了这个状态码。
“sensitive words”不等于命中了某个单词。术语黑名单是另一个独立的返回码 BLOCKLIST,而这句话对应的是 PROHIBITED_CONTENT,判断的是整条提示(加上传的图片、对话历史、系统指令)合起来表达的意图。所以逐个替换“敏感词”通常没用,而且政策明文禁止“规避滥用行为防范措施或安全过滤器,例如操纵模型以违反我们的政策”。有用的是改变整条提示表达的内容,方法见“定位触发点”一节。
The model output could not be generated:输出在生成后被拦
“The model output could not be generated. This output contains sensitive words that violate Google's Generative AI Prohibited Use Policy. If you think this was an error, send feedback.”
这句话表示输出侧拦截:提示通过了提交检查,模型已经生成,但生成结果被过滤器拦下。API 里对应 candidates[].finishReason: PROHIBITED_CONTENT,有的返回还带 finishMessage 字段,内容就是这句话。图片任务里另有 IMAGE_PROHIBITED_CONTENT(生成的图片含禁止内容)和 IMAGE_SAFETY(生成的图片有安全问题)。
输出侧拦截和输入侧的关键差别是:提示本身没有被判定违规,是模型顺着提示生成出了不该出现的东西。两种常见情形:一是提示写得含糊,模型自行补出了敏感元素(例如人像任务里年龄没写明,模型生成的人物被儿童安全过滤器拦下);二是提示要的就是一个过程或状态,模型生成时把它画得比你想的更露、更暴力。处理方法是把你要的最终画面写具体,而不是留给模型补全。
流式调用时要注意 SDK 文档的说明:SAFETY 类终止“When streaming, content is empty if content filters blocks the output”。也就是说流到一半被拦,你已经收到的片段不是完整回答,程序里要按失败处理,不能把半截文本当成结果。
This request was blocked by Gemini's filters:用户报告的第三种写法
“This request was blocked by Gemini's filters. They can occasionally trigger by mistake on safe coding, security, or biology-related queries. Please try rephrasing your prompt. You can send feedback or read more about our policies here.”
这句是用户报告的另一种报错写法,措辞里提到“coding, security, or biology-related queries”,说明它面向编程和技术类查询;具体由哪个界面显示,在公开文档里没有记载,上面只按用户报告的原文引用。它传达的信息和前两句一致:内容过滤器拦截,可能是误报,建议改写并发送反馈。技术场景的误报有真实案例,见下文 2026 年 9 月的安全测试报告。
返回码表:blockReason 与 finishReason 各自代表什么
下表把 Gemini API 会返回的拦截相关取值放在一起,英文释义是 SDK(google-genai 的类型定义)与 api-errors 文档的原句,中文是说明;截至 2026 年 9 月 30 日,安全设置文档最后更新于 2026 年 9 月 17 日,错误码文档最后更新于 2026 年 9 月 20 日。
| 位置 | 取值 | 官方释义(英文原句) | 含义 | 安全设置能否改变 |
|---|---|---|---|---|
promptFeedback.blockReason | SAFETY | The prompt was blocked for safety reasons. | 提示命中四类可调过滤器之一 | 能 |
promptFeedback.blockReason | PROHIBITED_CONTENT | The prompt was blocked because it contains prohibited content. | 提示触碰使用限制政策 | 不能 |
promptFeedback.blockReason | BLOCKLIST | …contains a term from the terminology blocklist. | 提示含术语黑名单里的词 | 不能 |
promptFeedback.blockReason | OTHER | …may be due to the prompt's language, or because it contains other harmful content. | 语言不支持,或其他有害内容;故障排查文档说也可能“违反服务条款或不受支持” | 不能 |
promptFeedback.blockReason | IMAGE_SAFETY | …contains content that is unsafe for image generation. | 提示(含上传图片)不适合用于图片生成 | 不能 |
candidates[].finishReason | SAFETY | Token generation stopped because the content potentially contains safety violations. | 输出命中四类可调过滤器之一 | 能 |
candidates[].finishReason | PROHIBITED_CONTENT | Token generation stopped for potentially containing prohibited content. | 输出触碰使用限制政策 | 不能 |
candidates[].finishReason | BLOCKLIST | …contains forbidden terms. | 输出含黑名单术语 | 不能 |
candidates[].finishReason | SPII | — | 输出含敏感个人身份信息 | 不能 |
candidates[].finishReason | RECITATION | — | 输出大段复述受版权保护的材料 | 不能,但可改提示(见下) |
candidates[].finishReason | IMAGE_SAFETY | Token generation stopped because generated images have safety violations. | 生成的图片有安全问题 | 不能 |
candidates[].finishReason | IMAGE_PROHIBITED_CONTENT | Image generation stopped because the generated images have prohibited content. | 生成的图片含禁止内容 | 不能 |
candidates[].finishReason | NO_IMAGE | The model was expected to generate an image, but none was generated. | 该出图却没出图,不一定是拦截 | 不适用 |
api-errors 文档另有一套小写的“generation blocked”代码:safety(Safety violations (harmful content) blocked the request.)、prohibited_content(Prohibited content guidelines blocked the request.)、blocklist、spii、recitation、language、image_safety、image_prohibited_content、image_recitation,以及生成错误 no_image。用户搜索的 prohibited_content 就是这套代码里的一个,含义与大写的 PROHIBITED_CONTENT 相同。
RECITATION 不是内容政策问题,而是输出与受版权材料高度重合。故障排查文档给的处理是让“提示 / 上下文尽可能独特”并调高 temperature。
MODEL_ARMOR 和 JAILBREAK 两个取值只存在于 Vertex AI,Gemini API 不会返回。Vertex AI 上 Imagen 的一组数字支持码(如 58061214、29310472)也属于 Vertex AI 文档,不是 Gemini API 的返回值,下文只借用它的类别列表说明图片过滤器看什么。
安全设置能不能救:决策规则
规则很短:如果 blockReason 或 finishReason 是 SAFETY,安全设置有用;是其他任何值,安全设置都没用。
安全设置只作用于四个可调类别,截至 2026 年 9 月 30 日文档给出的定义是:
| 类别 | 官方定义(英文原句) | 中文说明 |
|---|---|---|
HARM_CATEGORY_HARASSMENT | Negative or harmful comments targeting identity and/or protected attributes | 针对身份或受保护特征的负面、有害言论 |
HARM_CATEGORY_HATE_SPEECH | Content that is rude, disrespectful, or profane | 粗鲁、不尊重或亵渎的内容 |
HARM_CATEGORY_SEXUALLY_EXPLICIT | Contains references to sexual acts or other lewd content | 涉及性行为或其他淫秽内容 |
HARM_CATEGORY_DANGEROUS_CONTENT | Promotes, facilitates, or encourages harmful acts | 宣扬、协助或鼓励有害行为 |
每个类别可设阈值 OFF、BLOCK_NONE、BLOCK_ONLY_HIGH、BLOCK_MEDIUM_AND_ABOVE、BLOCK_LOW_AND_ABOVE,对应内容被判为 NEGLIGIBLE / LOW / MEDIUM / HIGH 概率时是否拦下。文档原句:“If the threshold is not set, the default block threshold is Off for Gemini 2.5 and 3 models.” 所以在这些模型上,你不设置时已经是最宽松的一档;再写一遍 BLOCK_NONE 对结果没有任何改变。
不可调的那一层,文档原句是:“The Gemini API has built-in protections against core harms, such as content that endangers child safety. These types of harm are always blocked and cannot be adjusted.” 文档没有列出这一层的全部类别,但从政策条文可以对应出主要范围:儿童性虐待或性剥削、未经同意的私密影像、以色情或性满足为目的的内容、暴力极端主义、协助自残、违法活动、侵犯隐私和知识产权、仇恨与骚扰、以欺骗为目的的冒充,以及规避安全过滤器本身。
显式设置安全设置仍然值得做,原因不是放宽,而是让行为可预期:模型换代时默认值可能变化(旧模型系列的默认值更严格,当前文档已不再列出),显式声明后跨模型行为一致,日志里也能看到每次拦截落在哪个类别。下面是 Python google-genai 的写法,同时演示如何读出 blockReason 和 finishReason 再决定程序怎么走:
hljs pythonfrom google import genai
from google.genai import types
client = genai.Client() # 读取环境变量 GEMINI_API_KEY
safety_settings = [
types.SafetySetting(
category=types.HarmCategory.HARM_CATEGORY_HARASSMENT,
threshold=types.HarmBlockThreshold.BLOCK_ONLY_HIGH,
),
types.SafetySetting(
category=types.HarmCategory.HARM_CATEGORY_HATE_SPEECH,
threshold=types.HarmBlockThreshold.BLOCK_ONLY_HIGH,
),
types.SafetySetting(
category=types.HarmCategory.HARM_CATEGORY_SEXUALLY_EXPLICIT,
threshold=types.HarmBlockThreshold.BLOCK_MEDIUM_AND_ABOVE,
),
types.SafetySetting(
category=types.HarmCategory.HARM_CATEGORY_DANGEROUS_CONTENT,
threshold=types.HarmBlockThreshold.BLOCK_MEDIUM_AND_ABOVE,
),
]
response = client.models.generate_content(
model="gemini-3.1-flash-image",
contents="一只橘猫坐在咖啡馆窗边,午后阳光,写实摄影风格",
config=types.GenerateContentConfig(safety_settings=safety_settings),
)
pf = response.prompt_feedback
if pf and pf.block_reason:
# 输入侧被拦:没有候选内容,只能改提示
print("输入被拦:", pf.block_reason.name, pf.block_reason_message)
elif response.candidates:
cand = response.candidates[0]
reason = cand.finish_reason.name if cand.finish_reason else "STOP"
if reason == "SAFETY":
# 只有这一种可以通过调整安全设置改变;先看是哪一类
for r in cand.safety_ratings or []:
print(r.category.name, r.probability.name, "blocked" if r.blocked else "")
elif reason in ("PROHIBITED_CONTENT", "BLOCKLIST", "SPII",
"IMAGE_SAFETY", "IMAGE_PROHIBITED_CONTENT"):
# 不可调:记录并向用户说明,不要自动重试
print("输出被拦:", reason, cand.finish_message)
else:
# 正常返回:图片模型的结果在 parts 里,图片是 inline_data,说明文字是 text
for part in cand.content.parts:
if part.inline_data:
with open("result.png", "wb") as f:
f.write(part.inline_data.data)
elif part.text:
print(part.text)
写生产代码时把三样东西一起写进日志:最终发给模型的完整文本(包括系统指令和拼接进去的对话历史)、blockReason / finishReason、safetyRatings。重试不会改变过滤器对同一条输入的判断,所以对 PROHIBITED_CONTENT 一类做指数退避重试只会浪费额度;重试应该保留给 429 rate_limit_exceeded 和 503 这类临时错误。
定位触发点:编号步骤
拦截判断的是整条输入合起来的意图,所以要用排除法找到是哪一部分把它推过了线。
- 只留最简提示。把提示删到只剩主体和动作(“一位成年女模特穿着白色连衣裙站在纯色背景前”),不带任何图片、系统指令、对话历史。能通过,说明问题在被删掉的部分;不能通过,说明主体本身就在禁止范围,直接跳到最后一步。
- 逐段加回。每次只加回一段(场景、服装细节、姿势、风格词、参考图),加到哪一段被拦,触发点就在那一段。2026 年 7 月论坛里的社区回复也是这个思路:检查“更长的输入里是否埋着可被标记的内容”。
- 改图任务做四组测试。上传原图 + 原提示、原图 + 简提示(“保持人物不变,把背景换成白色”)、一张无关的测试图 + 原提示、测试图 + 简提示。原图 + 简提示也被拦,问题在图片本身(人脸、儿童、名人、色情或粗俗内容都在图片过滤器的检查类别里);测试图 + 原提示被拦,问题在文字。
- 把“过程”改写成“最终画面”。“脱下”“撕开”“换掉身上的”这类写法描述的是一个动作过程,在图片任务里它指向的可能是一个私密过程,而不是你要的成品;直接描述最终画面(“模特穿着这件红色针织衫,全身,正面,棚拍”)表达的是同一个合法需求,过滤器看到的内容却不同。这是描述方式的改变,不是用替代词伪装同一个违规意图。
- 把年龄写明确。人像和换装任务里,“girl”“少女”“学生”这类词在没有其他年龄信息时会让模型或过滤器往未成年方向理解。写“成年女性”“30 岁左右的男性”能消除歧义。如果你的需求确实涉及未成年人形象,图片过滤器的儿童类别会持续拦截,这是政策明确保护的范围,应当停止。
- 换掉输入图片。人像换装、真人照片改图里,触发的经常是原图而不是文字:真人面部、名人、儿童、泳装或内衣照都在图片过滤器的检查类别里。用授权的成人模特图、或者先生成一个虚拟人物再改图,比反复改文字有效。
- 发送反馈。报错里的“send feedback”链接是官方给出的反馈入口,适合定位后仍然确认是误报的情形。截至 2026 年 9 月 30 日,下文两份 2026 年的开发者论坛报告都只有社区回复、没有 Google 官方回复,所以反馈不会立刻改变结果,但它是把误报送到 Google 手里的正式渠道。
- 停止。如果最简提示就被拦,或者去掉的每一段都是你需求的核心,那么这不是误报。政策原文允许的例外只有“相关内容属于教育、纪实、科学或艺术范畴,或者相关内容给公众带来的切实利益大于造成的危害”,日常生成任务很少落在这里。
图片过滤器会看什么,可以参考 Google Cloud 上 Imagen 的负责任 AI 文档(最后更新 2026 年 9 月 24 日)列出的类别:儿童、名人、名人或儿童、人物/人脸、个人信息、色情、暴力、危险、仇恨、粗俗、有害、第三方内容、禁止内容、其他。这份文档是 Vertex AI 的,类别列表用于理解“输入图和输出图都会被检查、检查的是哪些维度”,它的数字支持码不会出现在 Gemini API 的返回里。Gemini API 的图片模型页面(截至 2026 年 9 月 30 日列出 gemini-3.1-flash-lite-image、gemini-3.1-flash-image、gemini-3-pro-image 与旧的 gemini-2.5-flash-image)只写了一条使用要求:“Make sure you have the necessary rights to any images you upload. Don't generate content that infringe on others' rights, including videos or images that deceive, harass, or harm.” 所有生成的图片带 SynthID 水印。
如果按上面的步骤定位后确认提示本身合法(例如商品静物、成年模特的正常服装展示),却在同一个模型上反复失败,可以把同一条提示放到另一个图片模型上试:yingtu.ai 的在线生图工作台里有 GPT Image 2、Seedream 等模型,粘贴自己的 LaoZhang API key 即可使用,按张付费(Nano Banana Pro 在线生图:单张 $0.09、GPT Image 2 VIP 单张 $0.03,截至 2026 年 9 月 26 日)。它同样会拒绝违反政策的内容,换模型只对分类器误报有用,对真正违规的需求没有帮助。
误报案例:带日期的三份报告
误报是真实存在的,但都出现在特定形态的输入上,了解它们有助于判断自己是不是同类情形。
- 2026 年 9 月 14 日,Google AI 开发者论坛:开发者在 Antigravity 里用
gemini-3.8-flash让智能体总结测试结果,总结里含“adversarial mutation testing”、<script>注入测试用例、“mutant killers”等防御性安全测试用语,返回“The prompt could not be submitted…”。这是对安全测试词汇的误判。社区回复建议关闭安全设置或替换词语,但这个拦截是PROHIBITED_CONTENT层的,安全设置不起作用。截至 2026 年 9 月 30 日没有官方回复。 - 2026 年 7 月 7 日,同一论坛:
google-genaiSDK、已开通计费,请求gemini-omni-flash-preview时收到 HTTP 400invalid_request,消息“Input blocked: The prompt could not be submitted.…”。发帖人以为是模型访问资格问题,7 月 8 日的社区回复指出“that error means the safety filter is blocking your specific prompt content, not that youre ineligible for the model itself”,建议改写、用反馈链接,并检查长输入里有没有可被标记的内容。 - 2026 年 3 月 13 日,同一论坛:Veo 3.1 图生视频把一段“wholesome commercial storyboard”(正常的商业分镜)按儿童安全拦下,删掉与未成年人有关的描述后仍被拦。Veo 是另一个产品,但和 Gemini 共用同一套政策,这个案例说明儿童安全过滤器会在合法商业素材上过度触发,且对图片输入的判断不完全取决于文字。
三个案例的共同点:输入里有让分类器往“攻击”“儿童”方向理解的元素,而真实意图是合法的。处理路径都是同一条:定位触发元素,改写表达方式,发送反馈;都不是调安全设置能解决的。
不写代码的人能做什么
在 Gemini 应用和 Google AI Studio 里看到这句报错时,你看不到 blockReason,但能做的事和开发者是一样的,只是没有日志辅助:
- Gemini 应用:新开一个对话再试最简提示。对话历史是输入的一部分,前面几轮里的内容会跟着一起被判断。图片任务先不上传图片,只用文字生成一次,通过了再加图。
- Google AI Studio:“安全设置”面板只对应四个可调类别,它对
PROHIBITED_CONTENT拦截不起作用;系统指令框里的内容也算输入,清空后再试可以排除它。 - 第三方工具(AI Studio 反代、角色聊天、小说工具、编码智能体):报错是 Google 返回、工具原样转出的。工具开发者能决定的只有四类可调阈值;不可调的拦截换任何工具都一样。角色设定、世界观、前情摘要通常作为系统指令一起发送,其中的暴力或性描写会让每一轮请求都被拦,而不只是当前这句。
这三个位置里,被拦的都不是你的账号:同一个账号换一条合法提示就能继续用,账号层面的限制不是以这句报错的形式出现的。
什么时候应该停下
《生成式 AI 使用限制政策》(最后修改 2024 年 12 月 17 日)是这类拦截的依据,Gemini 应用、Google AI Studio 和 Gemini API 都适用。它禁止的内容里,与生成图片、文本最相关的是:儿童性虐待或性剥削材料;“facilitates non-consensual intimate imagery”(协助制作未经同意的私密影像);“Sexually explicit content -- for example, content created for the purpose of pornography or sexual gratification”(以色情或性满足为目的的内容);以欺骗为目的、未明确披露的冒充;以及“规避滥用行为防范措施或安全过滤器,例如操纵模型以违反我们的政策”。
最后一条决定了改写的边界。把“过程”改成“最终画面”、把年龄写明确、换掉触发的输入图,改变的是你表达的内容本身;找替代词、拆字、加符号让同一个违规意图溜过过滤器,属于“规避安全过滤器”,本身就是政策禁止的行为,而且账号层面的后果由 Google 决定。
常见问题
prohibited_content 是什么意思?
prohibited_content 是 Gemini API 错误码文档里“generation blocked”一组代码之一,官方释义是“Prohibited content guidelines blocked the request.”,即请求因触碰使用限制政策被拦。它与响应体里大写的 PROHIBITED_CONTENT(blockReason 或 finishReason 的取值)是同一件事。它不是可调的 SAFETY 类别,安全设置改不了它。
设置了 BLOCK_NONE 为什么还是被拦?
因为被拦的不是 SAFETY。BLOCK_NONE 只影响四个可调类别,而 Gemini 2.5 和 3 系列不设阈值时默认已经是 Off,所以你的设置没有改变任何东西。检查返回里的 blockReason / finishReason:如果是 PROHIBITED_CONTENT、BLOCKLIST、IMAGE_SAFETY 或 OTHER,只能改提示或输入图。
改图时提示写得很正常,为什么还是被拦?
多数情况下触发的是上传的图片,不是文字。图片过滤器会检查输入图里的人脸、儿童、名人、私密穿着等类别。用“原图 + 简提示”测一次:仍然被拦,就是原图的问题,换一张授权的成人模特图或先生成虚拟人物再改。
这是不是账号被封了?
不是。这句报错是针对当前这一条提示的内容拦截,换一条合法提示就能正常使用;2026 年 7 月 8 日 Google AI 开发者论坛的社区回复也明确说明它“不是你没有该模型的使用资格”。账号被限制时的表现形式与这句报错不同,两者无关。
输出被拦时已经收到的一半内容能用吗?
不建议用。SDK 文档写明流式输出被内容过滤器拦下时 content 为空,收到的片段是拦截前的中间状态,不是完整回答。程序里应按失败处理并向用户说明,再引导改写提示。