hljs json{"error":{"code":429,"message":"Resource has been exhausted (e.g. check quota).","status":"RESOURCE_EXHAUSTED"}}
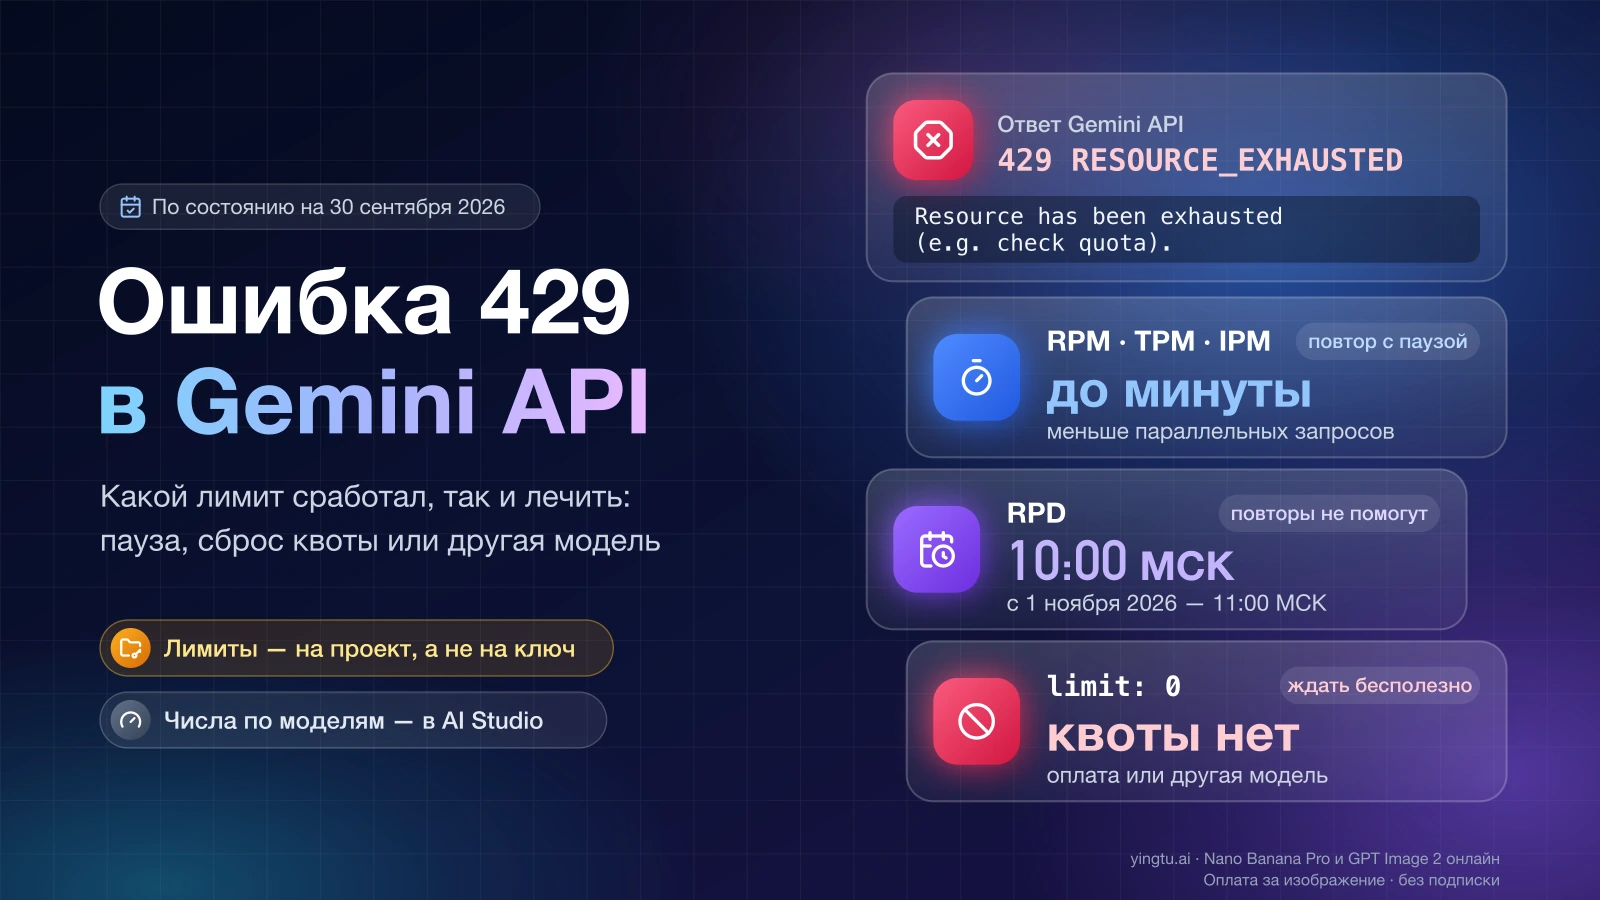
Ошибка 429 RESOURCE_EXHAUSTED с текстом «Resource has been exhausted (e.g. check quota).» — это ответ Gemini API о том, что ваш проект превысил один из своих лимитов: запросов в минуту (RPM), токенов в минуту (TPM), запросов в день (RPD), изображений в минуту (IPM) или лимит расходов за скользящие 10 минут. Что делать, зависит от того, какой именно лимит сработал: поминутный освобождается в течение минуты и лечится повтором с растущей паузой, суточный — только сбросом в полночь по тихоокеанскому времени или переходом на другую модель, а limit: 0 означает, что квоты на эту модель в проекте нет вовсе. Всё ниже — по состоянию на 30 сентября 2026 года, по документации Google о лимитах (обновлена 2 сентября 2026 года).
429 RESOURCE_EXHAUSTED: какой из лимитов сработал
Gemini API считает лимиты на проект, а не на ключ («Rate limits are applied per project, not per API key»), и 429 приходит при превышении любого из них, поэтому сначала нужно понять, какой счётчик закончился. Их шесть:
| Лимит (по состоянию на 30 сентября 2026 года) | Что считает | Когда освобождается | Что делать при 429 |
|---|---|---|---|
| RPM — requests per minute | Запросы к модели за минуту | В течение минуты | Повтор с экспоненциальной паузой, меньше параллельных запросов |
| TPM — tokens per minute | Входные токены за минуту: промпт, история диалога, файлы | В течение минуты | Повтор с паузой, более короткий контекст, большие файлы — не пачкой |
| RPD — requests per day | Запросы за сутки | В полночь по тихоокеанскому времени: 10:00 МСК до 1 ноября 2026 года, 11:00 МСК после | Ждать сброса или перевести запросы на модель, у которой квота осталась |
| IPM — images per minute | Изображения за минуту, только у моделей генерации изображений | В течение минуты | Повтор с паузой, меньше изображений за один заход |
| TPD — tokens per day | Токены за сутки, только у некоторых моделей | Время сброса в документации не указано | Ждать, крупные задания переносить в Batch API |
| Лимит расходов за 10 минут | Расходы проекта в скользящем 10-минутном окне: $10 на Tier 1, $50 на Tier 2, $200 на Tier 3 | По мере сдвига окна, не дольше 10 минут | Подождать до 10 минут или перейти на следующий уровень |
На странице документации о лимитах конкретных чисел RPM, TPM и RPD нет: у каждой модели и каждого уровня они свои, у preview- и экспериментальных моделей строже, а актуальные значения для вашего проекта показывает страница Rate limit в AI Studio.
Суточный лимит RPD обнуляется в полночь по тихоокеанскому времени; летом (PDT, UTC−7) это 10:00 по Москве. В ночь на 1 ноября 2026 года США переходят на зимнее время (PST, UTC−8), и сброс сдвигается на 11:00 МСК; Москва свои часы не переводит.
Как найти причину 429 за три шага
- Откройте aistudio.google.com/rate-limit и выберите проект, к которому привязан ключ. Сравните использование с лимитами по нужной модели: какой счётчик упёрся в потолок — RPM, TPM, RPD или IPM.
- Прочитайте полное тело ошибки, а не только статус. В нём бывает строка с названием квоты и значением лимита; на форуме Google для разработчиков в марте 2024 года, например, выкладывали вариант
limit 'GenerateContent request limit per …'. По такой строке видно, поминутная квота закончилась или суточная и не стоит ли тамlimit: 0. - Примените правило:
- если закончились RPM, TPM или IPM — повторите запрос с экспоненциальной паузой, как советует Google для 429, и уменьшите число одновременных запросов;
- если закончился RPD — повторы до сброса не помогут: дождитесь полуночи по тихоокеанскому времени или переведите запросы на другую модель, у которой в AI Studio остался запас;
- если в ошибке
limit: 0— у этой модели нет квоты в вашем проекте. На бесплатном уровне так отвечают Nano Banana 2, Nano Banana Pro, Veo, Gemini 3.1 Pro Preview и Computer Use: для них нужен проект с подключённой оплатой или другая модель. Какие модели доступны бесплатно, разобрано в статье «Бесплатные лимиты Gemini API: модели, квоты и ошибка 429»; - если сработал лимит расходов за 10 минут — подождите до 10 минут или переходите на уровень с более высоким лимитом.
Новый ключ в том же проекте ничего не даст: все ключи проекта делят одни и те же лимиты. Рабочие способы получить больше запросов — повышение уровня и Batch API, о них ниже.
В декабре 2025 года на форуме Google AI Developers и в Reddit многие сообщали о постоянных 429 на бесплатном уровне после того, как Google снизил бесплатные лимиты. Если код раньше работал, а теперь упирается в квоту, сверяйтесь с текущими числами в AI Studio, а не со старыми таблицами.
Повтор с экспоненциальной паузой: пример на Python
Повтор с растущей паузой помогает при поминутных лимитах и при перегрузке сервиса (503). При исчерпанном RPD, limit: 0, ошибках 400 и 403 он бесполезен, поэтому пример ниже повторяет только 429 и 503 и сразу останавливается, если квоты на модель нет. Это пример на библиотеке google-genai; ключ берётся из переменной окружения GEMINI_API_KEY, в код его не вписывайте.
hljs python# Пример: повтор только для 429 и 503 с экспоненциальной паузой
from random import uniform
from time import sleep
from google import genai
from google.genai import errors
client = genai.Client() # читает ключ из GEMINI_API_KEY
def generate_with_retry(model, contents, max_attempts=5):
for attempt in range(max_attempts):
try:
return client.models.generate_content(model=model, contents=contents)
except errors.APIError as e:
if e.code not in (429, 503):
raise # 400, 403, 404 повтором не исправить
if "limit: 0" in str(e):
raise # квоты на модель в проекте нет, ждать бесполезно
if attempt == max_attempts - 1:
raise
sleep(min(2 ** attempt, 32) + uniform(0, 1))
response = generate_with_retry("gemini-2.5-flash", "Кратко объясни, что такое RPM.")
print(response.text)
Паузы растут как 1, 2, 4, 8 секунд плюс случайная добавка до секунды: без неё несколько воркеров, получивших 429 одновременно, так же одновременно и повторят запрос. При max_attempts=5 все паузы вместе занимают около 15–20 секунд, а max_attempts=7 растягивает ожидание примерно до минуты — столько нужно, чтобы пережить полное минутное окно RPM или TPM. Если 429 остаётся и после последней попытки, скорее всего, закончилась суточная квота или сработал лимит расходов, и нужно смотреть AI Studio, а не увеличивать число повторов.
Сам повтор лечит симптом. Чтобы 429 приходил реже, ограничьте число одновременных запросов (очередь или семафор на стороне клиента), не отправляйте в каждом запросе всю историю диалога и большие файлы, если модели они не нужны, — это прямо снижает расход TPM.
Та же ошибка в Vertex AI, Gemini CLI и других клиентах
Строка «Resource has been exhausted» одинакова в разных продуктах Google, но квоты за ней разные. Прежде чем что-то менять, определите, чей лимит вы исчерпали:
| Где вы видите ошибку | Чья квота | Где смотреть |
|---|---|---|
| Запросы с ключом из Google AI Studio (Gemini API) | Проект AI Studio: RPM, TPM, RPD, IPM и лимит расходов вашего уровня | aistudio.google.com/rate-limit |
| Vertex AI (Gemini Enterprise Agent Platform) в Google Cloud | Отдельная система квот Google Cloud; лимиты AI Studio на неё не действуют, и наоборот | Страница Google Error code 429 для Vertex AI |
Gemini CLI: [API Error: Resource has been exhausted (e.g. check quota).] | Квота того проекта, чей ключ Gemini API подключён к CLI; бесплатный проект упирается в тот же RPD | Страница Rate limit в AI Studio для этого проекта |
Обёртки SDK и сторонние клиенты, например error: RetriableError: [RESOURCE_EXHAUSTED] | Та же квота проекта, просто в другой упаковке | Полный текст исходной ошибки и AI Studio |
В обсуждениях на GitHub (google-gemini/gemini-cli, issue #1848 от июня 2025 года) пользователи бесплатных проектов сообщали, что получали эту ошибку в CLI уже после трёх промптов.
Похожие ошибки, которые не связаны с квотой
Не каждый отказ Gemini API — это исчерпанный лимит. При 402, 400 и 403 повтор ничего не изменит, и только 503 тоже проходит после паузы:
| Код | Что означает (по документации Google на 30 сентября 2026 года) | Что делать |
|---|---|---|
| 402 | Баланс предоплаты дошёл до $0 | Пополнить баланс или включить автопополнение |
| 400 FAILED_PRECONDITION | Не выполнено условие запроса, например отключена оплата | Проверить статус биллинга проекта |
| 403 PERMISSION_DENIED | У ключа нет доступа к ресурсу | Проверить ключ и то, к какому проекту он относится |
| 503 UNAVAILABLE | Сервис временно перегружен | Повторить с экспоненциальной паузой — код выше это уже делает |
Уровни использования: как поднять лимиты
Лимиты привязаны к уровню использования (usage tier) проекта. Чем выше уровень, тем больше RPM, TPM и RPD и тем шире лимит расходов за 10 минут:
| Уровень (на 30 сентября 2026 года) | Условие | Потолок расходов уровня | Лимит расходов за 10 минут |
|---|---|---|---|
| Free | Активный проект или пробный период | — | — |
| Tier 1 | К проекту привязан платёжный аккаунт | $250 | $10 |
| Tier 2 | Оплачено от $100 и прошло 3 дня с первого платежа | $2 000 | $50 |
| Tier 3 | Оплачено от $1 000 и прошло 30 дней с первого платежа | $20 000–100 000+ | $200 |
Чтобы уйти с бесплатного уровня, достаточно подключить оплату; минимальное пополнение предоплаты — $5. В AI Studio можно задать собственный потолок расходов для проекта и автопополнение, чтобы не упереться в 402 посреди работы. Если лимитов платного уровня всё равно мало, у Google есть форма запроса повышенных лимитов для платных уровней.
Для больших несрочных заданий — разметки тысяч документов, пакетных переводов, ночной генерации — подходит Batch API. У него свои лимиты, отдельные от обычных запросов: до 100 одновременных пакетных заданий, входной файл до 2 ГБ и до 20 ГБ хранилища; лимит токенов в очереди зависит от модели и уровня.
Если запаса даже платного уровня не хватает, а ждать повышения лимитов некогда, можно подключить сторонний шлюз. Например, LaoZhang API отдаёт модели Gemini в нативном формате generateContent и в OpenAI-совместимом, списывая оплату с предоплаченного баланса за токены или за вызов. Это не сервис Google: квоты и условия у него свои, а на лимиты вашего проекта в AI Studio он никак не влияет.
Частые вопросы
Почему 429 приходит на первом же запросе?
Первым делом проверьте, нет ли в ошибке limit: 0: так отвечает модель, у которой нет квоты на вашем уровне, например Nano Banana Pro или Veo на бесплатном. Другие причины — строгие лимиты preview-модели или то, что квоту того же проекта уже расходуют другие ключи и приложения. Страница Rate limit в AI Studio покажет, какой из вариантов ваш.
Считаются ли в TPM токены ответа модели?
Нет. Документация Google описывает TPM как лимит входных токенов: промпт, системная инструкция, история диалога и приложенные файлы. Поэтому длинный контекст быстрее всего съедает TPM, даже если ответы короткие.
Сколько ждать после ошибки 429?
При поминутных лимитах (RPM, TPM, IPM) — до минуты, при лимите расходов — до 10 минут. При исчерпанном RPD ждать придётся до полуночи по тихоокеанскому времени: до 1 ноября 2026 года это 10:00 по Москве, после — 11:00.