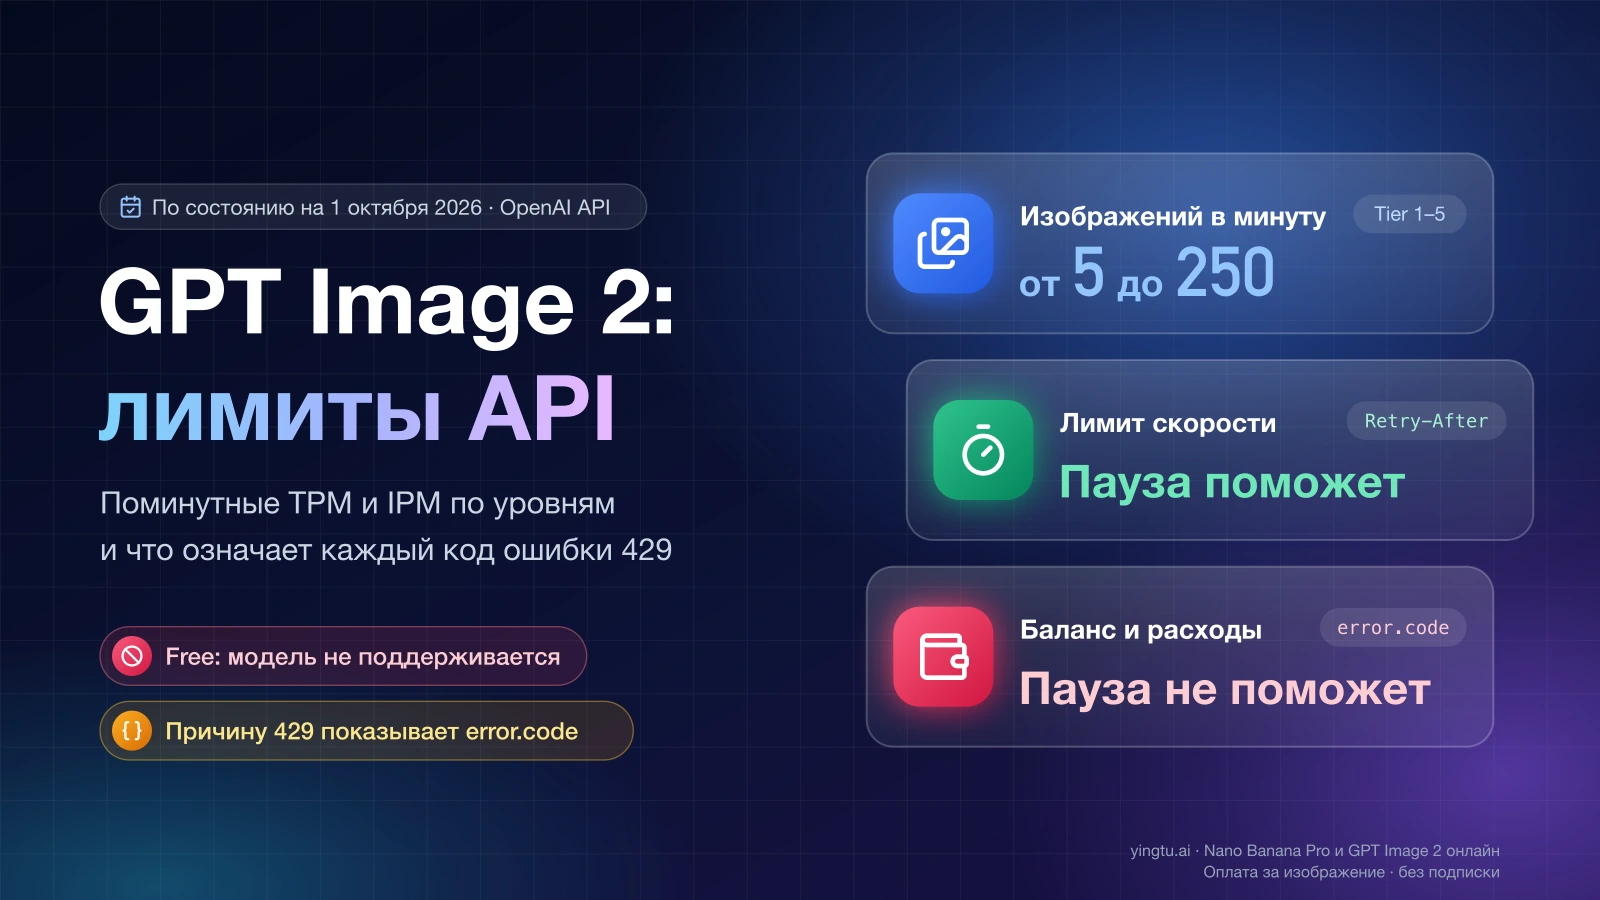
Лимиты GPT Image 2 в OpenAI API — это поминутные потолки модели gpt-image-2, которые зависят от уровня использования (usage tier) вашей организации: по состоянию на 1 октября 2026 года от 100 000 токенов и 5 изображений в минуту на Tier 1 до 8 000 000 токенов и 250 изображений в минуту на Tier 5, а на бесплатном уровне модель не поддерживается. Ответ HTTP 429 при этом не всегда означает, что исчерпан именно поминутный лимит. Тем же статусом OpenAI сообщает о пустом балансе, о пределе расходов и о месячном пределе использования, и в этих случаях ожидание ничего не меняет. Какой из лимитов сработал, видно по полю error.code в теле ответа.
Счётчик картинок в приложении ChatGPT к этим цифрам отношения не имеет: подписка и API оплачиваются и ограничиваются раздельно, а сообщение «No image generation quota is currently available.» приходит из приложения. Сколько изображений даёт каждый тариф ChatGPT и что означают его сообщения, разобрано в материале Лимит изображений в ChatGPT: сколько бесплатно и что делать.
Ошибка 429 у gpt-image-2: что означает каждый код
Код в поле error.code делит все ответы 429 на две группы: временные, которые проходят после паузы, и те, что требуют действия в настройках или в оплате. Названия и коды ниже взяты со страницы кодов ошибок OpenAI по состоянию на 1 октября 2026 года.
| Что пришло в ответе | Что именно закончилось | Помогут ли повторные попытки | Что делать |
|---|---|---|---|
| 429, «Rate limit reached for requests» | Поминутный лимит: запросы идут слишком часто | Да, после паузы | Выждать время из заголовка Retry-After, снизить темп, поставить запросы в очередь |
429, slow_down | Нагрузка выросла слишком резко, даже если поминутные лимиты не исчерпаны | Да, но на меньшей скорости | Снизить частоту запросов и наращивать её постепенно |
429, credit_balance_exhausted | Предоплаченный баланс | Нет | Пополнить баланс |
429, organization_spend_limit_exceeded | Жёсткий предел расходов, который вы сами задали для организации | Нет | Поднять предел в настройках организации |
429, project_spend_limit_exceeded | Такой же предел, заданный для проекта | Нет | Поднять предел в настройках проекта |
429, organization_usage_limit_exceeded | Месячный предел использования, назначенный OpenAI | Нет | Запросить более высокий одобренный предел или написать в поддержку |
503, server_is_overloaded | Ничего на вашей стороне: модель временно перегружена | Да, после паузы | Повторить позже, учитывая Retry-After, если он есть |
Про группу «нет» OpenAI пишет прямо: повторная отправка запросов при ошибках оплаты, расходов и квоты доступ не возвращает. Более того, неуспешные запросы тоже засчитываются в поминутный лимит, поэтому непрерывная повторная отправка одного и того же запроса не сработает.
У ошибок, связанных с оплатой, общее поле error.type может по-прежнему содержать insufficient_quota, так что точную причину показывает только error.code. Старые версии SDK и промежуточные сервисы иногда отдают лишь insufficient_quota или rate_limit_exceeded без новых кодов. Первое значение указывает на деньги или квоту, второе — на скорость.
Таблица уровней: TPM и IPM для gpt-image-2
Для gpt-image-2 опубликованы два поминутных лимита: TPM (tokens per minute, токенов в минуту) и IPM (images per minute, изображений в минуту). Запрос отклоняется, как только исчерпан любой из них, то есть тот, который закончился раньше. Уровень присваивается организации автоматически по сумме оплаченных счетов, и вместе с ним меняется месячный предел использования, который OpenAI одобряет для организации.
| Уровень | Сколько нужно оплатить | Месячный предел использования | TPM | IPM |
|---|---|---|---|---|
| Free | — (только в разрешённых регионах) | $100 | не поддерживается | не поддерживается |
| Tier 1 | $5 | $100 | 100 000 | 5 |
| Tier 2 | $50 | $500 | 250 000 | 20 |
| Tier 3 | $100 | $1 000 | 800 000 | 50 |
| Tier 4 | $250 | $5 000 | 3 000 000 | 150 |
| Tier 5 | $1 000 | $200 000 | 8 000 000 | 250 |
Данные по состоянию на 1 октября 2026 года: TPM и IPM — со страницы модели gpt-image-2 (снимок gpt-image-2-2026-04-21), пороги оплаты и месячные пределы — из руководства OpenAI по лимитам. Лимиты действуют для прямого OpenAI API.
Что это значит на практике. На Tier 1 пять изображений в минуту при равномерной подаче дают не больше 5 × 60 = 300 изображений в час; на Tier 2 потолок 20 × 60 = 1 200 в час. Если скрипт на Tier 1 одновременно запрашивает десять изображений, в минутный лимит укладываются только пять, каким бы ни был остаток денег на счёте.
Лимиты считаются на уровне организации и проекта, а не отдельного пользователя или ключа. Два сервиса с разными ключами одного проекта расходуют общий запас, и выпуск нового ключа ничего не добавляет. Лимиты привязаны к модели: страница gpt-image-2 перечисляет для неё генерацию и редактирование (v1/images/generations, v1/images/edits), Responses API и Batch и приводит одну таблицу уровней.
Для GPT Image 2.5 на странице модели gpt-image-2.5-flare приведена та же таблица уровней, что и для gpt-image-2.
Три разных потолка: минута, месяц и ваш собственный предел
Ошибка 429 при неизрасходованном месячном бюджете почти всегда объясняется тем, что сработал другой потолок. Их три, и они не зависят друг от друга.
- Поминутный лимит (TPM и IPM из таблицы выше). Восстанавливается сам с течением времени. Сюда же относится
slow_down: по описанию OpenAI, он отражает скорость роста нагрузки и возможен, когда запросы и токены в минуту ещё в пределах нормы. - Месячный предел использования, одобренный OpenAI для организации: от $100 на Tier 1 до $200 000 на Tier 5. При его достижении приходит
organization_usage_limit_exceeded. - Предел расходов, который вы задаёте сами для организации или проекта. OpenAI отдельно подчёркивает, что он не совпадает с одобренным месячным пределом. Настройка бывает двух видов: оповещение о расходах (spend alert) только отправляет уведомление, и запросы продолжают выполняться; жёсткий предел (hard spend limit) приводит к тому, что затронутые запросы возвращают 429.
Отдельно стоит предоплаченный баланс: когда он пуст, приходит credit_balance_exhausted, каким бы высоким ни был уровень.
Где увидеть лимиты своей организации
Опубликованная таблица показывает значения по умолчанию для уровня. Фактические цифры вашей организации видны на странице Limits в настройках на платформе OpenAI и могут отличаться от таблицы. Там же помечены модели с общим лимитом (shared limit), если семейство моделей расходует один запас.
Второй источник — заголовки ответа. По состоянию на 1 октября 2026 года руководство по лимитам перечисляет такие:
x-ratelimit-limit-requests,x-ratelimit-remaining-requests,x-ratelimit-reset-requests— предел, остаток и время до восстановления по запросам;x-ratelimit-limit-tokens,x-ratelimit-remaining-tokens,x-ratelimit-reset-tokens— то же по токенам;x-ratelimit-limit-project-tokens,x-ratelimit-remaining-project-tokens,x-ratelimit-reset-project-tokens— то же по токенам на уровне проекта;Retry-After— минимальное число секунд до следующей попытки, если заголовок присутствует.
Заголовка с остатком изображений в минуту в этом списке нет, поэтому расход IPM приходится считать на своей стороне: сколько запросов на генерацию ушло за последние 60 секунд. Про Retry-After в документации сказано, что он может сопровождать 429 из-за временного лимита и 503 из-за перегрузки модели, но его наличие не означает, что ошибку оплаты или квоты можно снять повтором.
Повторные попытки, которые не ухудшают ситуацию
Правило простое: если в ответе есть Retry-After, ждать не меньше указанного времени и добавить небольшую случайную задержку; если заголовка нет, увеличивать паузу экспоненциально со случайной добавкой (exponential backoff with jitter); ограничить число попыток и общее время; ошибки оплаты, расходов и квоты не повторять вовсе.
Официальные SDK уже повторяют подходящие ответы 429 и 503 автоматически. Если поверх этого написан собственный цикл, попытки перемножаются, поэтому встроенные повторы стоит либо отключить, либо учесть в расчёте. Ниже пример на Python с пакетом openai, в котором встроенные повторы отключены. Это иллюстрация логики, перед использованием проверьте её в своём окружении.
hljs pythonimport random
import time
from openai import InternalServerError, OpenAI, RateLimitError
client = OpenAI(max_retries=0) # встроенные повторы SDK отключены
# Коды, при которых ожидание не помогает: нужна оплата или смена настроек
NO_RETRY = {
"credit_balance_exhausted",
"organization_spend_limit_exceeded",
"project_spend_limit_exceeded",
"organization_usage_limit_exceeded",
"insufficient_quota",
}
def pause_for(error, attempt):
header = error.response.headers.get("retry-after")
try:
base = float(header)
except (TypeError, ValueError):
base = min(2 ** attempt, 30) # заголовка нет: растущая пауза
return base + random.uniform(0, 1)
def generate(prompt, attempts=5, max_total=120):
started = time.monotonic()
for attempt in range(attempts):
try:
return client.images.generate(model="gpt-image-2", prompt=prompt)
except RateLimitError as error: # HTTP 429
if error.code in NO_RETRY or error.type == "insufficient_quota":
raise
wait = pause_for(error, attempt)
except InternalServerError as error: # в том числе HTTP 503
if error.status_code != 503:
raise
wait = pause_for(error, attempt)
if time.monotonic() - started + wait > max_total:
break
time.sleep(wait)
raise RuntimeError("Лимит не освободился за отведённое время")
При slow_down одной паузы мало: после неё нужно вернуться к меньшей частоте запросов и поднимать её ступенями. Ориентир OpenAI для больших нагрузок — выше 1 млн входных токенов в минуту увеличивать трафик не более чем на 50 % каждые 15 минут.
Если задача не требует ответа сразу, часть объёма можно перенести в Batch API. Пакетные задания не расходуют поминутные лимиты обычных запросов; у них свой предел очереди, который считается во входных токенах, ожидающих обработки, отдельно по каждой модели. Цены пакетной обработки приведены в материале Цена GPT Image 2 API: сколько стоит одно изображение.
Отказы, которые похожи на лимит, но им не являются
Отказ в доступе к модели и отказ по региону ожиданием не снимаются, потому что это не лимиты скорости.
OpenAI может требовать подтверждения организации (verification) перед использованием отдельных продуктов, функций и моделей. Если запрос отклонён из-за доступа или неподтверждённой организации, паузы и повторы результата не дадут: сначала нужно получить доступ.
Ответ 403 «Country, region, or territory not supported» означает, что запрос пришёл из страны или региона, где OpenAI API не предоставляется. Список поддерживаемых стран и территорий опубликован у OpenAI; если вашей страны в нём нет, приходит именно этот ответ, и к уровням и лимитам он отношения не имеет.
Azure OpenAI: свои квоты и счёт в запросах
В Azure OpenAI (Microsoft Foundry) квота gpt-image-2 считается в запросах в минуту (RPM, requests per minute), а не в изображениях, и цифры не совпадают с таблицей OpenAI. Значения со страницы квот Microsoft, датированной 20 августа 2026 года:
| Уровень квоты Azure | gpt-image-2, Global Standard, RPM | gpt-image-2, Data Zone Standard, RPM | gpt-image-2.5-flare и gpt-image-2.5-sunburst, Global Standard, RPM |
|---|---|---|---|
| Tier 1 | 6 | 2 | 5 |
| Tier 2 | 12 | 4 | 5 |
| Tier 3 | 18 | 6 | 5 |
| Tier 4 | 24 | 8 | 5 |
| Tier 5 | 30 | 10 | 5 |
Всего у Azure семь уровней (Free и с 1-го по 6-й), они повышаются автоматически по мере использования, а дополнительную квоту запрашивают через форму. После 7 мая 2026 года Microsoft переводит квоты на учёт по подписке: сначала для отдельных моделей, а вскоре, как сказано в документации, для всех. При таком учёте развёртывания Global Standard одной модели и версии делят общий запас квоты на все регионы подписки, поэтому второе развёртывание в другом регионе пропускную способность не удваивает. У Data Zone Standard запас общий в пределах одной зоны данных.
Сторонние шлюзы и оплата по изображениям
Если gpt-image-2 вызывается через посредника, ошибка 429 относится к запасу самого посредника. Он делит свою квоту между всеми клиентами, и ваш уровень в OpenAI на неё не влияет: Tier 5 в собственной организации не спасёт от 429 у шлюза, а ожидание по таблице OpenAI может не совпасть с его правилами. Разбираться нужно по документации и статусу этого сервиса.
Тем, кому нужен результат GPT Image 2 без собственной организации в OpenAI, подходит оплата за каждое изображение. В YingTu GPT Image 2 стоит $0,03 за изображение по состоянию на 1 октября 2026 года, запросы идут через ваш собственный ключ LaoZhang API. Это отдельная система квот: уровень в OpenAI её не ограничивает и от её использования не повышается. Цена, размеры и пример запроса собраны на странице модели GPT Image 2 в YingTu.
Использовать API или второй аккаунт, чтобы уйти от лимитов ChatGPT или от своего уровня, не стоит: условия OpenAI запрещают обход лимитов и ограничений.
Частые вопросы
Почему приходит 429, если месячный бюджет ещё не израсходован?
Потому что поминутный лимит и месячный предел считаются независимо. На Tier 1 шестое изображение за минуту упирается в IPM при любом остатке бюджета. Второй вариант — резкий рост нагрузки и код slow_down. Посмотрите error.code: если там нет кода расходов или квоты, достаточно паузы и более ровного темпа.
Сбрасываются ли лимиты gpt-image-2 раз в сутки?
Нет, опубликованные лимиты gpt-image-2 поминутные: TPM и IPM. Суточного счётчика изображений в таблице модели нет по состоянию на 1 октября 2026 года. Месячный предел использования и предел расходов — отдельные денежные потолки, и поминутное восстановление на них не распространяется.
Как перейти на следующий уровень использования?
Уровень повышается автоматически по мере роста оплаченной суммы: $5 для Tier 1, $50 для Tier 2, $100 для Tier 3, $250 для Tier 4 и $1 000 для Tier 5 по состоянию на 1 октября 2026 года. Если упираетесь в месячный предел, назначенный OpenAI, более высокий одобренный предел запрашивается отдельно или через поддержку.
Расходует ли Batch API поминутные лимиты?
Нет. Пакетные задания не уменьшают поминутные лимиты обычных запросов. У Batch API собственный предел очереди, который считается во входных токенах, ожидающих обработки, по каждой модели.
Лимиты в Azure такие же, как в OpenAI API?
Нет. В Azure квота gpt-image-2 измеряется в запросах в минуту: от 6 RPM на Tier 1 до 30 RPM на Tier 5 для Global Standard по данным страницы Microsoft от 20 августа 2026 года. Управляют ею в подписке Azure, и уровень организации в OpenAI на неё не влияет.
Зависит ли лимит от количества API-ключей?
Нет. Лимиты заданы для организации и проекта, поэтому все ключи одного проекта расходуют общий запас.