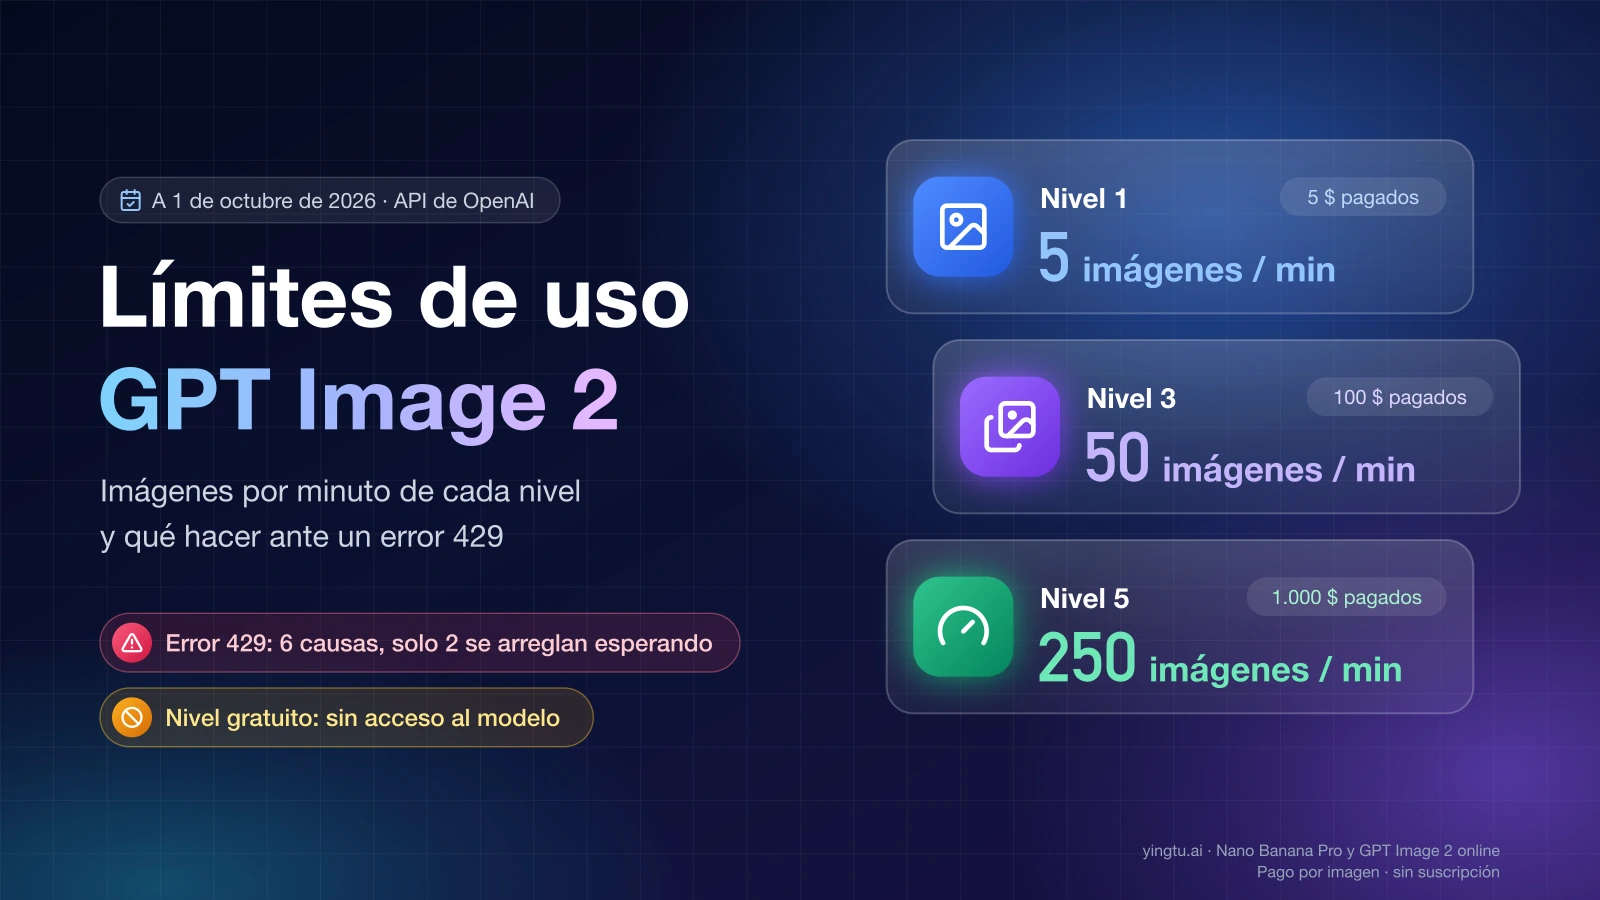
Los límites de uso de GPT Image 2 en la API de OpenAI son dos topes por minuto que dependen del nivel de uso de tu organización: tokens por minuto (TPM) e imágenes por minuto (IPM). A 1 de octubre de 2026, la página del modelo gpt-image-2 publica desde 100.000 TPM y 5 IPM en el nivel 1 hasta 8.000.000 TPM y 250 IPM en el nivel 5; el nivel gratuito no tiene acceso al modelo.
Un error 429 no siempre significa que hayas superado esos topes. La API devuelve HTTP 429 con seis causas distintas, entre ellas credit_balance_exhausted, slow_down y organization_usage_limit_exceeded, y solo dos se resuelven esperando. Las otras cuatro piden añadir saldo o subir un límite, y repetir la llamada no cambia nada. El campo error.code de la respuesta indica cuál te ha tocado.
Todo lo anterior vale para la API. El generador de imágenes de ChatGPT es un sistema aparte: OpenAI no publica un número de imágenes por plan, la suscripción a ChatGPT no incluye uso de la API y los avisos de la aplicación, como "No image generation quota is currently available.", no guardan relación con los niveles de la API. Los cupos de la aplicación y el significado de sus avisos están en Límite de imágenes en ChatGPT gratis: cuántas hay y qué hacer.
Límites de gpt-image-2 por nivel en la API de OpenAI
La tabla siguiente reproduce los límites publicados para gpt-image-2 (versión gpt-image-2-2026-04-21). Se aplican a las llamadas a v1/images/generations, v1/images/edits y a la API Responses.
| Nivel de uso | TPM (tokens por minuto) | IPM (imágenes por minuto) |
|---|---|---|
| Gratuito (Free) | No disponible | No disponible |
| Nivel 1 (Tier 1) | 100.000 | 5 |
| Nivel 2 (Tier 2) | 250.000 | 20 |
| Nivel 3 (Tier 3) | 800.000 | 50 |
| Nivel 4 (Tier 4) | 3.000.000 | 150 |
| Nivel 5 (Tier 5) | 8.000.000 | 250 |
Límites de gpt-image-2 en la API de OpenAI a 1 de octubre de 2026. Fuente: página del modelo en developers.openai.com.
Los dos topes cuentan a la vez y salta el que se alcance antes. En el nivel 1, 5 imágenes por minuto equivalen como máximo a 5 × 60 = 300 imágenes por hora, y solo si ninguna petición agota antes los 100.000 tokens por minuto. La guía de límites de tasa añade tres detalles que cambian el diagnóstico:
- Los límites se fijan por organización y por proyecto, no por usuario ni por clave. Dos scripts del mismo proyecto consumen del mismo tope.
- Cada modelo tiene sus propios límites, y algunas familias de modelos comparten uno; la página Limits de la consola lo marca como límite compartido.
- Las peticiones fallidas también cuentan para el límite por minuto, de modo que reenviar sin pausa una llamada rechazada alarga el bloqueo.
La tabla pública es la referencia general. Los números que rigen para ti son los de la página Limits de tu organización en la consola de OpenAI, que pueden ser distintos.
Para GPT Image 2.5, la página del modelo gpt-image-2.5-flare muestra la misma tabla de niveles que gpt-image-2.
Cómo se sube de nivel y qué límite mensual trae cada uno
El nivel sube de forma automática a medida que crece lo que has pagado por la API. Cada nivel lleva además un límite de uso mensual aprobado por OpenAI, que es independiente de los topes por minuto.
| Nivel de uso | Requisito | Límite de uso mensual aprobado |
|---|---|---|
| Gratuito | Estar en una zona geográfica admitida | 100 $ al mes |
| Nivel 1 | 5 $ pagados | 100 $ al mes |
| Nivel 2 | 50 $ pagados | 500 $ al mes |
| Nivel 3 | 100 $ pagados | 1.000 $ al mes |
| Nivel 4 | 250 $ pagados | 5.000 $ al mes |
| Nivel 5 | 1.000 $ pagados | 200.000 $ al mes |
Niveles de uso de la API de OpenAI a 1 de octubre de 2026. Fuente: guía de límites de tasa de OpenAI.
Ese límite mensual lo asigna OpenAI y es distinto de los límites de gasto que tú puedes configurar para la organización o para un proyecto. Son tres contadores diferentes, y cada uno produce su propio código de error cuando se agota.
Error 429 en gpt-image-2: qué límite has tocado según el código
El código que acompaña al 429 decide la acción: esperar, frenar, recargar saldo o subir un límite. La página de códigos de error de OpenAI pide leer error.code porque el campo más general, error.type, puede seguir diciendo insufficient_quota en todos los errores de facturación.
| Código o mensaje | Qué límite es | ¿Sirve reintentar? | Dónde se arregla |
|---|---|---|---|
| "Rate limit reached for requests" | Tope por minuto (TPM o IPM) de tu nivel | Sí, tras la espera que marque Retry-After | Espaciar las llamadas; a medio plazo, subir de nivel |
slow_down | El tráfico ha crecido demasiado deprisa | Sí, con menos volumen | Bajar el ritmo y aumentarlo de forma gradual |
credit_balance_exhausted | Saldo de prepago agotado | No | Añadir saldo en la facturación de la consola |
organization_spend_limit_exceeded | Límite de gasto que configuraste para la organización | No | Subir ese límite en los ajustes de la organización |
project_spend_limit_exceeded | Límite de gasto que configuraste para el proyecto | No | Subir ese límite en los ajustes del proyecto |
organization_usage_limit_exceeded | Límite de uso mensual aprobado por OpenAI | No | Pedir un límite aprobado mayor o contactar con soporte |
503 server_is_overloaded | Ninguno tuyo: el modelo está saturado | Sí, tras Retry-After | Esperar; no depende de tu cuenta |
Códigos documentados por OpenAI a 1 de octubre de 2026. Las versiones antiguas del SDK y algunos intermediarios pueden mostrar solo insufficient_quota o rate_limit_exceeded.
"Rate limit reached for requests": espera lo que indique Retry-After
"Rate limit reached for requests" significa que envías peticiones más rápido de lo que permite tu nivel, y se resuelve espaciándolas. Si la respuesta trae la cabecera Retry-After, ese valor es el mínimo de segundos que debes esperar. Si quieres generar más imágenes por minuto de forma sostenida, la única vía es el nivel siguiente.
slow_down: el volumen ha subido demasiado rápido
slow_down aparece cuando el ritmo de peticiones aumenta de golpe, y puede saltar aunque sigas por debajo de tus límites por minuto. Mide la velocidad a la que crece el tráfico, no el total. La solución es reducir el volumen y volver a subirlo poco a poco. Como orientación, OpenAI recomienda que, por encima de 1.000.000 de tokens de entrada por minuto, el tráfico no crezca más de un 50 % cada 15 minutos.
credit_balance_exhausted: no queda saldo de prepago
credit_balance_exhausted indica que la organización no tiene crédito de prepago, y la llamada no volverá a funcionar hasta que añadas saldo. Esperar o reintentar no restablece el acceso.
organization_spend_limit_exceeded y project_spend_limit_exceeded: tu propio tope de gasto
Estos dos códigos avisan de que se ha alcanzado un límite de gasto estricto definido por ti o por quien administra la organización. OpenAI distingue dos controles: la alerta de gasto envía una notificación y el tráfico continúa, mientras que el límite de gasto estricto hace que las peticiones afectadas devuelvan 429. Por eso puedes recibir un 429 con saldo de sobra y sin haber agotado el uso mensual: basta con que el proyecto tenga un tope más bajo. Se corrige subiendo ese tope.
organization_usage_limit_exceeded: el límite mensual aprobado por OpenAI
organization_usage_limit_exceeded significa que la organización ha llegado al límite de uso mensual que OpenAI le tiene aprobado, el de la segunda tabla. No lo puedes subir desde tus ajustes de gasto: hay que solicitar un límite aprobado mayor o escribir a soporte.
503 server_is_overloaded: no depende de tu cuenta
Un 503 con server_is_overloaded es una saturación temporal del modelo. No lo causa tu saldo ni tu nivel, y se trata igual que un límite de tasa pasajero: esperar y reintentar con pausas.
Rechazos que no son un límite de tasa
Un 403 por país, región o territorio no admitido, o una respuesta que deniega el acceso al modelo o exige verificar la organización, no se resuelven esperando. OpenAI puede pedir la verificación de la organización antes de permitir el uso de ciertos productos, funciones o modelos, y esa verificación es una condición de acceso. Si la respuesta es de este tipo, revisa el estado de la organización en la consola en lugar de programar reintentos.
Cabeceras de la respuesta y reintentos
La cabecera Retry-After, cuando viene, es el dato más útil para decidir cuánto esperar. Puede aparecer en un 429 por límite de tasa temporal y en un 503 por saturación. Según la documentación, su presencia no implica que un error de cuota o de facturación se arregle reintentando.
El resto de las cabeceras informa de peticiones y tokens: x-ratelimit-limit-requests, x-ratelimit-remaining-requests, x-ratelimit-reset-requests y sus equivalentes -tokens, además de las de ámbito de proyecto, como x-ratelimit-remaining-project-tokens. A 1 de octubre de 2026, la tabla de cabeceras no incluye ninguna que cuente imágenes por minuto, así que el margen de IPM que te queda se consulta en la página Limits de la consola.
Las reglas de reintento que da OpenAI son estas:
- Espera como mínimo lo que indique
Retry-Aftery añade un pequeño retardo aleatorio. - Si no hay cabecera, aplica retroceso exponencial (exponential backoff) con variación aleatoria.
- Pon un máximo de intentos y un tiempo total máximo.
- No reintentes los errores de saldo, gasto o cuota.
- Los SDK oficiales ya reintentan por su cuenta los 429 y 503 que lo admiten; desactiva ese comportamiento o tenlo en cuenta para no anidar dos bucles de reintento.
El ejemplo siguiente aplica esas reglas con el SDK openai de Python. Es un esquema para adaptar que no se ha ejecutado contra la API; los nombres de las excepciones y de los códigos proceden de la documentación.
hljs pythonimport random
import time
from openai import OpenAI, RateLimitError, InternalServerError
# max_retries=0: los reintentos los decide este código, no el SDK
client = OpenAI(max_retries=0)
NO_REINTENTAR = {
"credit_balance_exhausted",
"organization_spend_limit_exceeded",
"project_spend_limit_exceeded",
"organization_usage_limit_exceeded",
"insufficient_quota",
}
def generar(prompt, intentos=5):
for intento in range(intentos):
try:
return client.images.generate(model="gpt-image-2", prompt=prompt)
except RateLimitError as e:
if e.code in NO_REINTENTAR or e.type == "insufficient_quota":
# Saldo, gasto o cuota: hace falta una acción en la consola
raise
cabecera = e.response.headers.get("retry-after")
except InternalServerError as e:
if e.status_code != 503:
raise
cabecera = e.response.headers.get("retry-after")
espera = float(cabecera) if cabecera else min(2 ** intento, 60)
time.sleep(espera + random.uniform(0, 1))
raise RuntimeError("Se agotaron los intentos sin respuesta")
Con slow_down, reintentar al mismo ritmo no basta: además de la pausa, reduce el número de llamadas simultáneas antes de volver a subirlo.
Batch tiene su propia cola
gpt-image-2 también está disponible en la API Batch, y las peticiones enviadas por Batch no consumen los límites por minuto de las llamadas normales. Batch tiene un límite distinto, medido en tokens de entrada en cola por modelo. Si tu trabajo no necesita la imagen al momento, pasarlo a Batch libera los topes de TPM e IPM para el tráfico en tiempo real. Los precios de esa modalidad están en Precio de GPT Image 2 en la API: coste por imagen y por tokens.
En Azure OpenAI los límites son otros
En Azure, la cuota de gpt-image-2 se mide en peticiones por minuto (RPM), no en imágenes por minuto, y sus niveles no coinciden con los de la API de OpenAI. Estos son los valores de la página de cuotas de Microsoft Foundry, fechada el 20 de agosto de 2026:
| Nivel en Azure | gpt-image-2, Global Standard | gpt-image-2, Data Zone Standard |
|---|---|---|
| Nivel 1 | 6 RPM | 2 RPM |
| Nivel 2 | 12 RPM | 4 RPM |
| Nivel 3 | 18 RPM | 6 RPM |
| Nivel 4 | 24 RPM | 8 RPM |
| Nivel 5 | 30 RPM | 10 RPM |
Cuotas de Azure OpenAI según la página de Microsoft del 20 de agosto de 2026, consultadas a 1 de octubre de 2026.
gpt-image-2.5-flare y gpt-image-2.5-sunburst tienen 5 RPM en Global Standard en todos los niveles del 1 al 5. Azure maneja siete niveles (gratuito y del 1 al 6) que suben automáticamente con el uso, y la cuota adicional se pide con el formulario de solicitud de cuota.
Microsoft está pasando la cuota de Azure a una gestión por suscripción: empezó después del 7 de mayo de 2026 con algunos modelos y, según su documentación, pronto la aplicará a todos. Con ese esquema, los despliegues Global Standard del mismo modelo y versión comparten una sola cuota entre todas las regiones de la suscripción, y los de Data Zone Standard comparten una por zona de datos. Crear un segundo despliegue en otra región no añade capacidad.
Si llamas al modelo a través de un intermediario
Cuando usas GPT Image 2 mediante una pasarela o un revendedor, el 429 que recibes corresponde al cupo propio de ese proveedor y no tiene que ver con tu nivel en OpenAI. Subir de nivel en tu organización de OpenAI no lo arregla; la información útil está en el panel y en los avisos de ese proveedor.
Lo mismo ocurre a la inversa con YingTu: genera con GPT Image 2 a 0,03 $ por imagen (a 1 de octubre de 2026), facturado por imagen a través de tu propia clave de LaoZhang API. Es un sistema de cuota independiente de tu organización de OpenAI: tu nivel allí no lo limita, y usarlo tampoco te hace subir de nivel en OpenAI. Puede interesarte si quieres pagar por imagen sin gestionar niveles; el precio, los tamaños y un ejemplo de llamada están en la ficha de GPT Image 2 en YingTu.
Preguntas frecuentes
¿Por qué recibo un 429 si no he gastado mi presupuesto mensual?
Porque el 429 cubre varios límites y el gasto mensual es solo uno. Puedes haber superado el tope por minuto de tu nivel (por ejemplo, 5 imágenes por minuto en el nivel 1, a 1 de octubre de 2026) o tener un límite de gasto estricto más bajo en el proyecto. El valor de error.code distingue un caso del otro.
¿Los límites de GPT Image 2 se reinician cada día?
La tabla publicada para gpt-image-2 solo contiene límites por minuto, TPM e IPM, a 1 de octubre de 2026; no figura ningún tope diario. El límite de uso aprobado, en cambio, es mensual. La guía de OpenAI menciona métricas diarias (RPD y TPD) para otros casos, y la página Limits de tu consola muestra cuáles se aplican a tu organización.
¿Cómo quitar el error 429 en gpt-image-2?
Lee error.code. Con "Rate limit reached for requests" o slow_down, espera lo que indique Retry-After y baja el ritmo. Con credit_balance_exhausted, añade saldo. Con los códigos de límite de gasto, sube el tope en los ajustes. Con organization_usage_limit_exceeded, pide a OpenAI un límite aprobado mayor.
¿Puedo pedir que me suban de nivel antes de tiempo?
OpenAI sube el nivel automáticamente cuando aumenta el importe pagado: 50 $ para el nivel 2, 100 $ para el nivel 3, 250 $ para el nivel 4 y 1.000 $ para el nivel 5, a 1 de octubre de 2026. Lo que sí se puede solicitar es un límite de uso mensual aprobado más alto.
¿Usar la API sirve para seguir generando cuando ChatGPT me avisa del límite?
Son cuentas de consumo separadas: la API se factura aparte y la suscripción a ChatGPT no le da saldo. Puedes usar la API como producto distinto, con su propio pago y sus propios límites. Los términos de OpenAI prohíben eludir los límites de tasa, de modo que abrir una segunda cuenta para saltarse un cupo queda fuera de lo permitido.