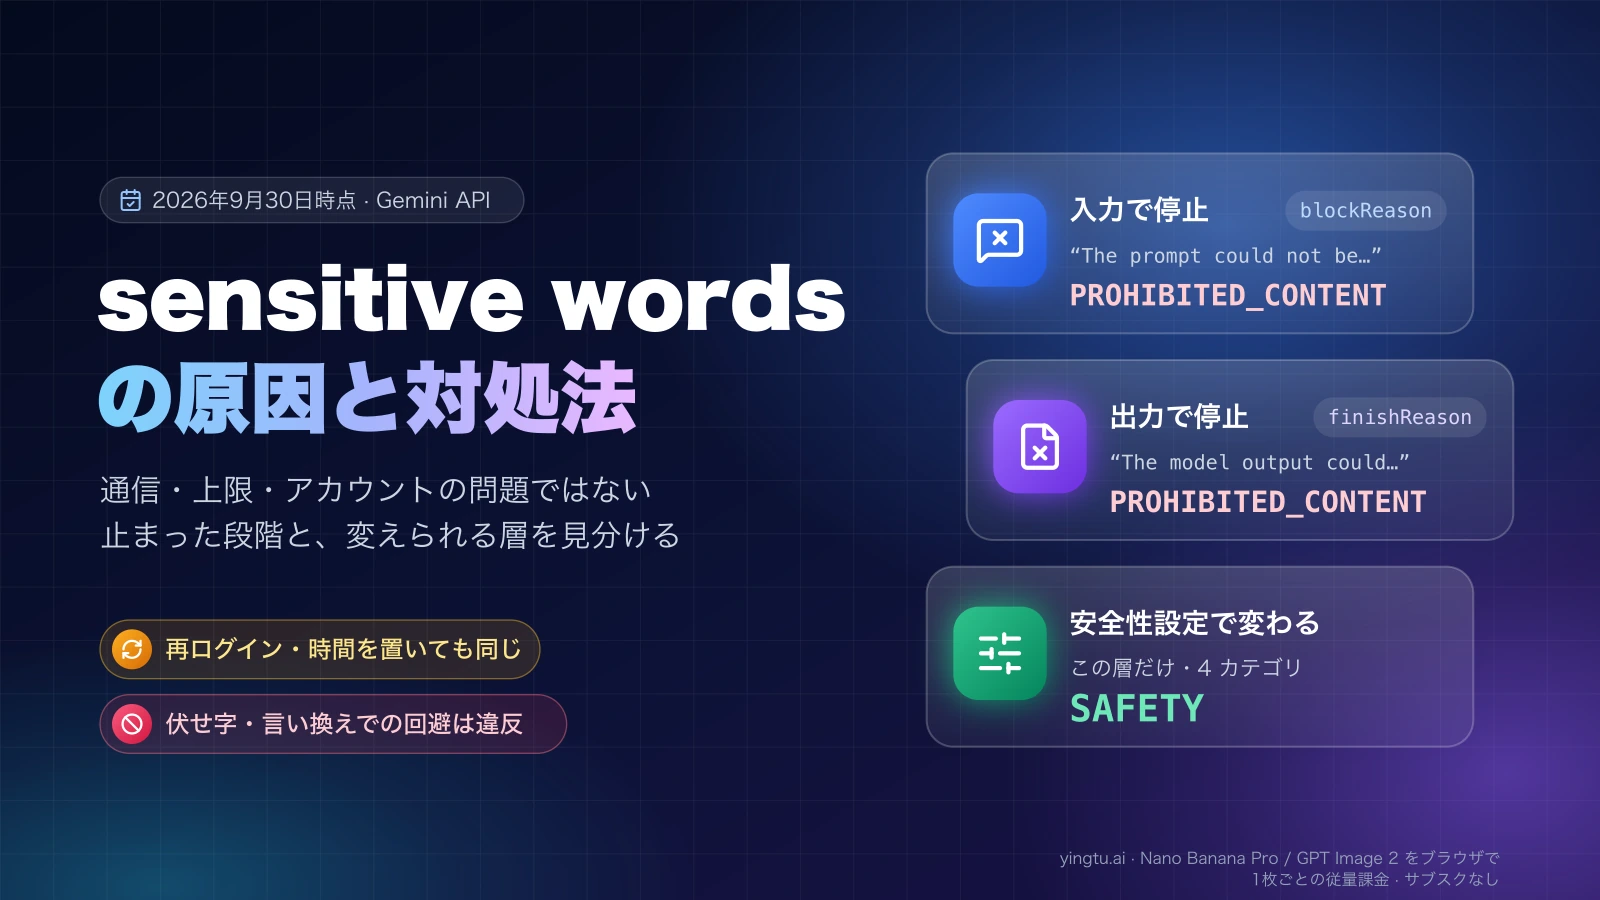
「The prompt could not be submitted. The prompt contains sensitive words that violate Google's Generative AI Prohibited Use Policy. Try rephrasing the prompt. If you think this was an error, send feedback.」は、Gemini アプリ、Google AI Studio、Gemini API を使うツールが、送信したプロンプトをコンテンツポリシーの基準で止めたときに返すメッセージです。通信エラーでも、キャッシュや Cookie の不具合でも、利用上限、地域制限、アカウントの制限でもありません。ブラウザを替えても、再ログインしても、時間を置いても、同じ内容のプロンプトは同じように止まります。変えるべきものは、プロンプトの中身か、アップロードした画像か、あるいは依頼そのものです。
同じ系統のメッセージは 3 種類あり、止まった段階が違います。2026年9月30日時点の Gemini API 公開リファレンスと開発者フォーラムの報告を突き合わせると、次のように対応します。
| 表示された文言 | 止まった段階 | Gemini API での表れ方 | 安全性設定で変わるか | 最初にやること |
|---|---|---|---|---|
| The prompt could not be submitted. The prompt contains sensitive words… | 入力(モデルに届く前) | promptFeedback.blockReason: PROHIBITED_CONTENT、SDK では HTTP 400 invalid_request「Input blocked: …」 | 変わらない | 原因箇所の切り分け(後述の手順) |
| The model output could not be generated. This output contains sensitive words… | 出力(生成の途中) | candidates[].finishReason: PROHIBITED_CONTENT、finishMessage に同じ英文 | 変わらない | 会話履歴・貼り付け素材・最終的な絵柄の指定を見直す |
| This request was blocked by Gemini's filters. They can occasionally trigger by mistake… | 入力(開発ツール系で報告) | 対応するコードは公開リファレンスに記載がない | 変わらない | 目的と立場を明示して書き直す |
(画面の文言なし)finishReason: SAFETY | 出力 | safetyRatings に 4 カテゴリの確率 | 変わる | しきい値を明示する |
以下、3 つの英文をそれぞれ 1 節ずつ説明し、その後にコード表、切り分け手順、コードの書き方、止めるべき依頼の境界をまとめます。
The prompt could not be submitted. The prompt contains sensitive words that violate Google's Generative AI Prohibited Use Policy. Try rephrasing the prompt. If you think this was an error, send feedback.
このメッセージは、プロンプトがモデルに届く前の入力チェックで止まったことを意味し、Gemini API では promptFeedback.blockReason が PROHIBITED_CONTENT になり、候補(candidates)は 1 つも返りません(2026年9月30日時点の Gemini API リファレンス)。Google AI Studio や Gemini API 上に作られたツールの画面ではこの英文がそのまま表示され、画面によっては「Generative AI Prohibited Use Policy」と「send feedback」がリンクになっています。google-genai SDK 経由では例外になり、HTTP 400 invalid_request の本文に「Input blocked: The prompt could not be submitted. …」が入ります。2026年7月7日に Google AI Developers Forum へ投稿された gemini-omni-flash-preview の報告がこの形でした(2026年9月30日時点)。
「sensitive words」という表現から、特定の単語に一致したと考えがちですが、判定は文脈込みの分類器によるものです。Google のリファレンスは PROHIBITED_CONTENT を「The prompt was blocked because it contains prohibited content.」(禁止コンテンツが含まれているためプロンプトがブロックされた)としか説明していません。単語の一致で止まる層は別にあり、それは BLOCKLIST(用語ブロックリスト)という別のコードで返ります。だから 1 語を伏せ字にしても通らないことが多く、逆に、危険な単語が 1 つもないのに止まることもあります。2026年9月14日に同フォーラムへ投稿された例では、コーディングエージェントが書いたテスト結果の要約(「adversarial mutation testing」、<script> を使った注入テストのケース、「mutant killers」という語)がこのメッセージで止まりました。防御目的のセキュリティ用語が攻撃と分類された誤検知です。
このメッセージが出ても、アカウントが制限されたわけでも、そのモデルの利用資格がないわけでもありません。2026年7月7日の報告に対する翌日の回答(Google 社員ではないコミュニティの回答)は「その特定のプロンプトの内容を安全フィルタが止めているのであって、モデルの利用資格がないという意味ではない」と整理し、言い換え、フィードバックリンクの利用、「長い入力の中に引っかかる要素が埋まっていないか」の確認を勧めています。請求を有効にしていても、別の地域からでも、同じ内容なら同じように止まります。
この層は安全性設定では変わりません。メッセージが指している「Generative AI Prohibited Use Policy」の日本語版は「生成 AI の使用禁止に関するポリシー」(最終更新日 2024年12月17日)で、後述のとおり、ここに該当する依頼はどう書き換えても通りませんし、通そうとする行為自体が同じポリシーの違反になります。
The model output could not be generated. This output contains sensitive words that violate Google's Generative AI Prohibited Use Policy. If you think this was an error, send feedback.
こちらは入力チェックを通過した後、モデルが生成している途中の内容が止められたメッセージで、Gemini API では候補の finishReason が PROHIBITED_CONTENT、finishMessage にこの英文が入ります(2026年9月30日時点)。SDK の定義文は「Token generation stopped for potentially containing prohibited content.」(禁止コンテンツを含む可能性があるためトークン生成が停止した)です。ストリーミングで受け取っている場合、途中まで届いていた本文が空になることがあります。これは SAFETY の定義に「When streaming, content is empty if content filters blocks the output.」と明記された動作で、クライアント側は本文が空で finishReason だけが入るレスポンスを前提に書く必要があります。
入力が通って出力で止まる場合、原因はプロンプトの語そのものではなく、モデルが向かった方向にあります。多いのは 3 つの形です。
- 長い会話履歴やシステムプロンプトの中に、単独では問題にならない要素が積み重なっている。最初のターンは通り、何ターンか後で止まるのはこの形です。
- 翻訳・要約・校正のために貼り付けた素材(小説の一節、SNS の投稿、チャットログ)の中身が、出力に再現された時点で禁止範囲に触れる。入力チェックは「翻訳してください」という依頼を見て通し、出力チェックは翻訳結果を見て止めます。
- 画像生成で、プロンプトが曖昧なためにモデルが選んだ絵柄(服装、年齢の印象、体勢、実在人物への類似)が画像フィルタに触れる。画像の場合はコードが
IMAGE_PROHIBITED_CONTENT(生成画像に禁止コンテンツ)やIMAGE_SAFETY(生成画像に安全性違反)になり、NO_IMAGE(画像が生成されなかった)とは区別されます。
対処は入力ブロックと逆向きです。プロンプトの言葉を削るより、最終的にどんな文章・どんな絵が欲しいかを具体的に書き足します。人物なら成人であることと服装・場面を明示し、要約なら「暴力的な描写の詳細は要約に含めない」のように出力の範囲を先に決めます。長い会話で止まった場合は、新しいセッションで必要な文脈だけを渡し直すと、履歴の積み重ねが原因かどうかが分かります。
This request was blocked by Gemini's filters. They can occasionally trigger by mistake on safe coding, security, or biology-related queries. Please try rephrasing your prompt. You can send feedback or read more about our policies here.
この文言はユーザーが貼り付けて報告しているメッセージで、Gemini API の公開リファレンスには対応するコードの記載がなく、どの画面に表示されるかも公開情報にありません(2026年9月30日時点)。文面自体が「安全なコーディング、セキュリティ、生物学の質問で誤って作動することがある」と認めている点が特徴で、上の 2 つと同じポリシー系統のフィルタが、開発者向けの画面で言い換えられたものと読めます。
対処の考え方は入力ブロックと同じですが、コーディングやセキュリティの文脈では「言い換え」の意味が違います。攻撃手法の名前を伏せ字にしても、分類器は文脈を見るので効果は期待できませんし、伏せ字で通そうとする行為は後述の「保護フィルタを回避する」に当たります。代わりに、防御側の立場と対象システムを先に書きます。「自社サービスの入力検証テストのため、想定される XSS ペイロードを検出する正規表現を書いてください」のように、誰が何のためにその出力を使うのかを明示するのは、単語を隠すことではなく依頼を正確にすることです。それでも止まる場合は、メッセージ内のフィードバックリンクから誤検知として報告し、その依頼を分割する(テストケースの生成と、検出ロジックの実装を別のプロンプトにする)のが現実的です。
PROHIBITED_CONTENT・BLOCKLIST・SAFETY:安全性設定で変わる層と変わらない層
Gemini API のブロックは、安全性設定(safetySettings)で調整できる SAFETY と、設定に関係なく常に働く PROHIBITED_CONTENT・BLOCKLIST・組み込み保護の 2 層に分かれます(2026年9月30日時点の安全性設定ドキュメント、最終更新 2026年9月18日)。安全性設定のドキュメントには「児童を危険にさらすようなコンテンツなど、重大な有害性に対する保護機能が組み込まれています。このような種類の有害性は常にブロックされ、調整することはできません。」と書かれています。組み込み保護のカテゴリを網羅した一覧は公開されていません。
コードは 3 か所に出ます。入力ブロックは promptFeedback.blockReason(大文字)、出力ブロックは candidates[].finishReason(大文字)、エラーコード一覧ページでは小文字の名前です。2026年9月30日時点の定義を並べます。
入力 blockReason | 出力 finishReason | エラーコード | Google の定義(原文) | 意味 | 安全性設定で変わるか |
|---|---|---|---|---|---|
SAFETY | SAFETY | safety | The prompt was blocked for safety reasons. / Token generation stopped because the content potentially contains safety violations. | 4 カテゴリのいずれかで確率がしきい値を超えた | 変わる |
PROHIBITED_CONTENT | PROHIBITED_CONTENT | prohibited_content | The prompt was blocked because it contains prohibited content. / Token generation stopped for potentially containing prohibited content. | 使用禁止ポリシーの分類器が止めた | 変わらない |
BLOCKLIST | BLOCKLIST | blocklist | The prompt was blocked because it contains a term from the terminology blocklist. / Token generation stopped because the content contains forbidden terms. | 用語ブロックリストに一致した | 変わらない |
OTHER | OTHER | language | …may be due to the prompt's language, or because it contains other harmful content. | 言語未対応、利用規約違反、その他(エラーコード一覧では言語未対応が language) | 変わらない |
| — | SPII | spii | Sensitive Personally Identifiable Information restrictions blocked the request. | 機密性の高い個人情報 | 変わらない |
| — | RECITATION | recitation | (既存コンテンツの再現) | 学習データや既存の文章をそのまま出そうとした | 変わらない(プロンプトを固有にし、temperature を上げる) |
IMAGE_SAFETY | IMAGE_SAFETY | image_safety | Safety violations blocked image generation. | 画像の安全性違反 | 調整方法の記載がない |
| — | IMAGE_PROHIBITED_CONTENT | image_prohibited_content | Image generation stopped because the generated images have prohibited content. | 生成画像に禁止コンテンツ | 変わらない |
| — | NO_IMAGE | no_image | The model was expected to generate an image, but none was generated. | 画像が生成されなかった(ブロックではなく生成エラー) | 該当なし |
「変わる」のは SAFETY だけです。安全性設定で調整できる 4 カテゴリと、ドキュメントの日本語名は次のとおりです(2026年9月30日時点)。
カテゴリ(HARM_CATEGORY_…) | 日本語名 | ドキュメントの説明 |
|---|---|---|
HARASSMENT | ハラスメント | アイデンティティや保護対象属性をターゲットとする否定的または有害なコメント |
HATE_SPEECH | ヘイトスピーチ | 失礼、無礼、または不適切なコンテンツ |
SEXUALLY_EXPLICIT | 露骨な性表現 | 性行為やわいせつな内容に関する情報が含まれるコンテンツ |
DANGEROUS_CONTENT | 危険 | 有害な行為を促進、助長、または推奨するコンテンツ |
しきい値は OFF(安全フィルタをオフにする)、BLOCK_NONE(確率に関係なく常に表示する)、BLOCK_ONLY_HIGH、BLOCK_MEDIUM_AND_ABOVE、BLOCK_LOW_AND_ABOVE の 5 段階で、確率は NEGLIGIBLE・LOW・MEDIUM・HIGH の 4 段階で safetyRatings に返ります。
ここで判断を分ける事実が 1 つあります。同じドキュメントに「しきい値が設定されていない場合、Gemini 2.5 モデルと 3 モデルのデフォルトのブロックしきい値はオフです。」とあります(2026年9月30日時点)。つまり、Gemini 2.5 系や 3 系のモデルで、安全性設定を何も指定していないのに止まったなら、SAFETY の層は最初から働いていません。止めたのは PROHIBITED_CONTENT・BLOCKLIST・組み込み保護のいずれかで、設定をいくら変えても結果は同じです。
判定ルールとしてまとめると次のようになります。
finishReasonがSAFETYで、safetyRatingsのどれかがMEDIUM以上なら、そのカテゴリのしきい値を明示することで通る可能性があります。blockReasonがSAFETYなら、入力プロンプト自体が 4 カテゴリに触れています。トラブルシューティングのドキュメントは「API 呼び出しで設定したフィルタに照らしてプロンプトを見直す」ことを勧めています(2026年9月30日時点)。PROHIBITED_CONTENT・BLOCKLIST・IMAGE_PROHIBITED_CONTENTなら、設定は関係ありません。内容を変えるか、誤検知として報告するか、やめるかの 3 択です。OTHERなら、プロンプトの言語が未対応か、利用規約に反するか、そのモデルが対応していない依頼の可能性があります。
原因箇所を切り分ける手順
止まった原因を推測で直そうとすると、無関係な語を削って何度も失敗します。次の順に進めると、原因の位置を送信回数の少ないうちに特定できます。
- 記録する。表示された英文、画面(Gemini アプリ/Google AI Studio/自分のコード/第三者ツール)、モデル名、コードで取れるなら
blockReasonかfinishReasonを控えます。入力ブロックか出力ブロックかがこの時点で決まります。 - 最小プロンプトで送る。依頼の核だけを 1〜2 文にして送ります。これが止まるなら、原因は依頼の中心にあり、言い換えではなく依頼の見直しが必要です。
- 段落ごとに戻す。最小プロンプトが通ったら、元のプロンプトを段落(または箇条書き 1 項目)単位で戻していきます。止まった段落が原因箇所です。長い会話やシステムプロンプトがある場合は、それらを外した状態から始めます。
- 画像編集は 4 通り試す。「元の画像 × 元のプロンプト」「元の画像 × 短いプロンプト(例:背景を白にする)」「無難な別の画像 × 元のプロンプト」「無難な別の画像 × 短いプロンプト」の 4 通りを送ります。元の画像を使った 2 通りだけが止まるなら、原因はプロンプトではなくアップロードした画像です。
- 原因箇所を、意図する最終結果として書き直す。禁止されそうな語を別の語に置き換えるのではなく、欲しい絵柄・文面を具体的に書きます。人物は成人であること、服装、場面、用途を明示し、「girl」「teen」のように年齢が曖昧な語を親密・暴力的な文脈と組み合わせないようにします。
- それでも止まるなら、メッセージ内のフィードバックリンクから報告します。誤検知の報告先はここだけです。
- 依頼が後述の禁止範囲に入っているなら、ここでやめます。
手順 4 でアップロード画像が原因と分かった場合、画像フィルタが何を見ているかの手がかりになるのが、Google Cloud の Vertex AI Imagen 向け「責任ある AI」ページのカテゴリ一覧です(2026年9月24日更新、2026年9月30日時点)。児童、著名人、人物/顔、性的、暴力、個人情報、第三者コンテンツ、ヘイト、有害、下品、危険という分類で、それぞれにサポートコードが割り当てられています。これは Vertex AI の Imagen 用の分類で、Gemini API の画像モデルはこれらのコードではなく上の表の finishReason を返しますが、「写真の中の人物が未成年に見える」「著名人に似ている」「顔が大きく映っている」といった要素が画像側の判定対象になることは、この一覧から読み取れます。商品写真にモデルが写っている、家族写真に子どもが写っている、という場合はこの分類に該当しやすく、対処は人物の写っていない画像に差し替えるか、人物の写り方を変えることです。
コードで安全性設定を明示し、blockReason と finishReason を読む
自分のコードから呼んでいる場合、やることは 2 つだけです。安全性設定を明示して SAFETY の層を自分の管理下に置くこと、そしてレスポンスの promptFeedback と finishReason を必ず読むことです。Python の google-genai SDK での例を示します(2026年9月30日時点の SDK のフィールド名)。
hljs pythonfrom google import genai
from google.genai import errors, types
client = genai.Client() # 環境変数 GEMINI_API_KEY を使用
prompt = "ここに依頼文を入れる"
CATEGORIES = [
"HARM_CATEGORY_HARASSMENT",
"HARM_CATEGORY_HATE_SPEECH",
"HARM_CATEGORY_SEXUALLY_EXPLICIT",
"HARM_CATEGORY_DANGEROUS_CONTENT",
]
config = types.GenerateContentConfig(
safety_settings=[
types.SafetySetting(category=c, threshold="BLOCK_ONLY_HIGH")
for c in CATEGORIES
],
)
try:
response = client.models.generate_content(
model="gemini-2.5-flash",
contents=prompt,
config=config,
)
except errors.ClientError as e:
# 入力ブロックが HTTP 400 として返る形。本文に "Input blocked: The prompt could not be submitted. ..." が入る
print("HTTP", e.code, e.message)
raise
fb = response.prompt_feedback
if fb is not None and fb.block_reason:
# 入力ブロック。candidates は返らない
print("入力ブロック:", fb.block_reason.name, fb.block_reason_message)
elif response.candidates:
cand = response.candidates[0]
if cand.finish_reason and cand.finish_reason.name not in ("STOP", "MAX_TOKENS"):
# 出力ブロック。ストリーミングでは本文が空になり得る
print("出力ブロック:", cand.finish_reason.name, cand.finish_message)
for rating in cand.safety_ratings or []:
print(rating.category.name, rating.probability.name)
else:
print(response.text)
読み方は次のとおりです。errors.ClientError に入ったら入力ブロックの一形態で、本文の「Input blocked: …」を記録します。prompt_feedback.block_reason に値があれば入力ブロックで、PROHIBITED_CONTENT なら設定変更は無意味、SAFETY なら safety_settings の対象です。finish_reason が SAFETY なら safety_ratings のどのカテゴリが MEDIUM 以上かを見て、そのカテゴリのしきい値を判断します。PROHIBITED_CONTENT や IMAGE_PROHIBITED_CONTENT なら、プロンプトと画像の中身に戻ります。
しきい値を BLOCK_ONLY_HIGH にしているのは、既定の Off と同じ結果になる依頼が多い一方で、safety_ratings を自分で確認する習慣がつくからです。OFF や BLOCK_NONE にしても PROHIBITED_CONTENT は 1 件も減りません。ゲートウェイや自社サービスから呼んでいる場合は、最終的にモデルへ送った全文(システムプロンプトと履歴を含む)と block_reason/finish_reason/safety_ratings を同じログ行に残すと、後から切り分け手順を再現できます。
画像モデル(gemini-3.1-flash-image、gemini-3-pro-image など、2026年9月30日時点の Gemini API 画像生成ドキュメントに載っているモデル)でも同じフィールドを読みます。画像側の finish_reason は IMAGE_SAFETY・IMAGE_PROHIBITED_CONTENT・NO_IMAGE になります。同ドキュメントは、アップロードする画像に必要な権利を持っていること、他者の権利を侵害する画像や、欺く・嫌がらせをする・害を与える画像を生成しないことを求めています。
誤検知は実際に起きる:日付付きの事例
分類器によるブロックなので、正当な依頼が止まることはあります。フィードバックリンクが用意されているのはそのためです。公開されている報告を 3 件挙げます(いずれも 2026年9月30日時点で閲覧できる Google AI Developers Forum の投稿)。
- 2026年9月14日:
gemini-3.8-flashをコーディングエージェント経由で使い、防御的なセキュリティテストの要約(変異テスト、注入テストのケース)が「The prompt could not be submitted. …」で止まった報告。Google からの公式回答はなく、コミュニティの返信は安全性設定の無効化や語の置き換えを提案していますが、この層は安全性設定では変わらず、置き換えは回避行為に当たります。 - 2026年7月7日:
google-genaiSDK、請求有効、gemini-omni-flash-previewで HTTP 400「Input blocked: …」。投稿者はモデルの利用資格を疑いましたが、翌日の回答は「利用資格ではなく、その特定のプロンプトの内容をフィルタが止めている」と整理しました。 - 2026年3月13日:Veo 3.1 の画像から動画への生成で、健全な商業用の絵コンテが児童安全の誤検知として止まり、未成年への言及を消しても止まり続けた報告。Veo は別の製品ですが、同じポリシー系統の児童安全フィルタが保守的に働くことを示す例です。
3 件に共通するのは、単語を変えても解決していないこと、そして報告先がフィードバックリンクしかないことです。誤検知だと判断したら、切り分け手順で特定した最小の再現プロンプトを添えて報告するのが、最も早く分類器の改善につながる行動です。
書き換えても通らない依頼:ポリシーの境界
「生成 AI の使用禁止に関するポリシー」(最終更新日 2024年12月17日、2026年9月30日時点)は、Gemini アプリ、Google AI Studio、Gemini API のすべてに適用され、次の内容を禁止しています。
- 児童の性的虐待や児童の搾取に関連しているコンテンツ。画像で未成年に見える人物を性的・親密な文脈に置く依頼は、成人だと書き足しても対象です。
- 本人の同意なく作成された親密な状況のシナリオ・画像・動画。実在の人物(有名人、知人、元交際相手)の親密・暴力的な場面がここに入ります。
- 性的描写が露骨なコンテンツ(ポルノや性的満足を目的として作成されたコンテンツ)。
- それが自分ではないと明かさずになりすます行為。
- 不正使用対策や保護フィルタを回避する(たとえば、ポリシーに違反するようにモデルを操作する)行為。
最後の項目が重要です。禁止範囲の内容を、伏せ字、隠語、「これはフィクションです」という前置き、別言語への置き換えで通そうとする行為は、それ自体がポリシー違反です。フィルタに止められた依頼がこの一覧に入っているなら、切り分け手順は不要で、やめることが正しい対処になります。
同じポリシーは「教育、記録、科学、芸術の観点に基づく考慮が必要な場合、または社会にもたらされる実質的な利益が有害性を上回る場合は、例外を設けることがあります」とも述べています。医療解説、事件報道の要約、美術史の記述などが止まった場合は、その目的と用途をプロンプトに明示することが、回避ではなく正当な書き直しになります。
正当なプロンプトが繰り返し止まるとき
切り分けを終え、依頼が禁止範囲に入っていないことを確認し、フィードバックも送ったのに、同じ正当な画像プロンプトが繰り返し止まる場合は、分類器の違う画像モデルで同じプロンプトを試すのが次の一手です。ブラウザ上の生成スタジオ YingTu では、自分の LaoZhang API キーを貼り付ける方式でGPT Image 2 や Seedream に同じプロンプトを投げられ、料金はサブスクリプションではなく 1 枚ごとの従量課金です(2026年9月26日時点:GPT Image 2 VIP $0.03、Seedream 5.0 Flash $0.018、Nano Banana Pro $0.09)。ただし条件が 2 つあります。Nano Banana Pro は Google の gemini-3-pro-image そのものなので、Google 側で PROHIBITED_CONTENT になった依頼は同じ結果になる可能性が高く、試す意味があるのは GPT Image 2 や Seedream のような別提供元のモデルです。そして YingTu 自身も出力を検査し、ポリシーに違反する内容は同じように拒否します。別のモデルで試すのは誤検知の切り分け手段であり、上の境界を越える手段ではありません。
よくある質問
prohibited_content とはどういう意味ですか
Gemini API が「使用禁止ポリシーに該当する内容が含まれる」と判定して生成を止めたことを示すコードで、安全性設定では変えられません(2026年9月30日時点)。大文字の PROHIBITED_CONTENT は promptFeedback.blockReason(入力ブロック)と candidates[].finishReason(出力ブロック)に、小文字の prohibited_content はエラーコード一覧に出る同じ意味の名前です。エラーコード一覧の定義は「Prohibited content guidelines blocked the request.」です。HTTP 429 の rate_limit_exceeded(利用上限)や 400 の failed_precondition とは別物で、上限や課金の状態を直しても解消しません。
安全性設定を BLOCK_NONE にしても止まるのはなぜですか
安全性設定が効くのは SAFETY の層だけで、PROHIBITED_CONTENT・BLOCKLIST・児童の安全などの組み込み保護は「常にブロックされ、調整することはできません」と安全性設定のドキュメントに明記されているからです(2026年9月30日時点)。しかも Gemini 2.5 系・3 系では未設定時の既定がすでにオフなので、BLOCK_NONE にしても状態は変わりません。止まった原因はレスポンスの blockReason か finishReason に書かれています。そこが SAFETY でなければ、設定は無関係です。
「背景を白にする」のような無難な編集指示なのに失敗するのはなぜですか
原因はプロンプトではなく、アップロードした画像である可能性が高いです。画像を入力に含む依頼では、画像の中身(人物が未成年に見える、著名人に似ている、顔が大きく映っている、肌の露出が多い)も判定対象になります。切り分け手順の 4 通りテストで、「無難な別の画像 × 同じプロンプト」だけが通るなら確定です。対処は、人物の写っていない画像に差し替える、人物の写り方を変える、あるいは人物部分を切り出してから編集を依頼することです。Gemini アプリで画像生成ができないときも、まずこの画像側の判定か、上の 2 種類のメッセージのどちらに当たるかを見分けます。
アカウントが制限されたのですか
このメッセージは特定のプロンプトに対する判定で、アカウント状態とは無関係です。2026年7月7日の開発者フォーラムの報告でも、請求を有効にした正規のアカウントで同じメッセージが出ており、回答は「モデルの利用資格の問題ではない」と整理しています(2026年9月30日時点)。アカウントの制限や利用上限は、HTTP 403 permission_denied や 429 rate_limit_exceeded のように別のコードで返ります。別のプロンプトは通るのに特定のプロンプトだけ止まるなら、内容の問題です。
「This prompt contains sensitive words that violate Google's Responsible AI practices」という似たメッセージは同じものですか
似ていますが、こちらは Google Cloud の Vertex AI で Imagen を使ったときの入力フィルタの文言です(2026年9月24日更新のページ、2026年9月30日時点)。出力側では「Your current safety filter threshold filtered out 2 generated images. You will not be charged for blocked images.」のように、フィルタで除かれた枚数と課金されないことが表示されます。Vertex AI の Imagen には児童・著名人・人物/顔・性的・暴力などのカテゴリごとにサポートコードがあり、Gemini API の finishReason とは別の体系です。どちらも「通信ではなく内容による停止」という点は同じで、対処の考え方(切り分け、最終結果としての書き直し、画像の差し替え)も同じです。