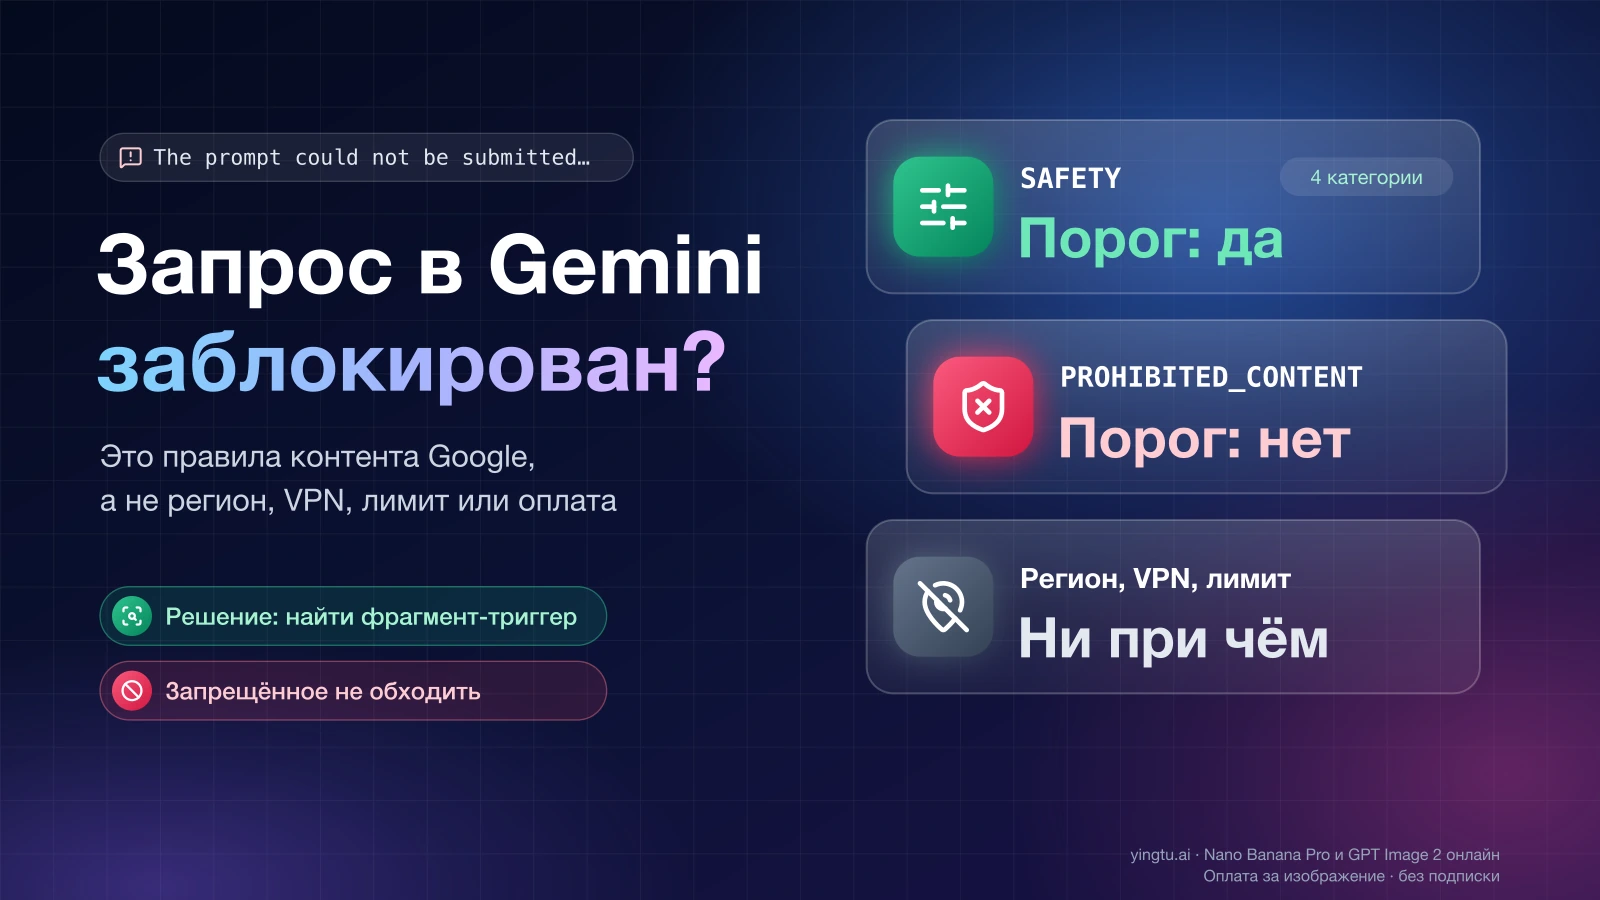
Сообщение «The prompt could not be submitted. The prompt contains sensitive words that violate Google's Generative AI Prohibited Use Policy. Try rephrasing the prompt. If you think this was an error, send feedback.» — это блокировка запроса по правилам контента Google. Она не связана со страной, VPN, лимитами, оплатой или состоянием аккаунта и одинаково срабатывает в любом регионе. Региональная ошибка выглядит иначе: в ней говорится о местоположении («Gemini недоступен в вашей стране», «User location is not supported»), а не о «sensitive words». Если в ответе видно именно эту строку, менять сервер или подключение бесполезно — нужно смотреть на содержание запроса (промпта) и на код блокировки.
Короткий ответ, который годится для всех трёх интерфейсов — приложения Gemini, Google AI Studio и Gemini API:
- Блокировка на входе («The prompt could not be submitted…») означает, что модель ваш запрос не увидела; блокировка на выходе («The model output could not be generated…») — что запрос прошёл, а сгенерированный ответ отклонён.
- «Sensitive words» — не совпадение со словарём. Срабатывает оценка смысла всего запроса вместе с вложениями, историей чата и системными инструкциями, поэтому замена отдельных слов, как правило, ничего не меняет.
- Настройки безопасности Gemini API помогают только при коде
SAFETY. КодыPROHIBITED_CONTENT,BLOCKLISTи встроенная защита (детская безопасность, реальные люди в изображениях) на порог блокировки не реагируют — по состоянию на 30 сентября 2026 года это прямо записано в документации Gemini API. - Если запрос легитимен, найдите фрагмент-триггер минимальным запросом, перепишите его под нужный итоговый результат и отправьте отзыв по ссылке из сообщения. Если запрос попадает под правила запрещённого использования, блокировка сработала правильно и обходить её нельзя.
Как отличить блокировку по контенту от ошибки региона, лимита и оплаты
Блокировка по правилам контента узнаётся по тексту сообщения: в нём всегда есть слова «Prohibited Use Policy», «sensitive words», «filters» или код PROHIBITED_CONTENT. Всё, что говорит о местоположении, квоте или платеже, — другая ошибка с другим решением. Таблица собрана по документации Gemini API и по строкам, которые пользователи копируют из интерфейсов, по состоянию на 30 сентября 2026 года.
| Что видно в ответе | Что это | Где встречается | Что делать |
|---|---|---|---|
| «The prompt could not be submitted. The prompt contains sensitive words that violate Google's Generative AI Prohibited Use Policy…» | Блокировка запроса на входе по правилам контента | Приложение Gemini, Google AI Studio; в API — как promptFeedback.blockReasonMessage рядом с "blockReason": "PROHIBITED_CONTENT" | Локализовать триггер и переписать запрос; см. раздел ниже |
HTTP 400 invalid_request, текст начинается с «Input blocked: The prompt could not be submitted…» | Та же блокировка на входе, показанная SDK как ошибка запроса | Gemini API через google-genai | Не менять ключ и модель — причина в содержании запроса |
«The model output could not be generated. This output contains sensitive words…» или finishReason: PROHIBITED_CONTENT | Блокировка сгенерированного ответа на выходе | Приложение Gemini, Google AI Studio, Gemini API | Сузить формулировку нужного результата, повторить |
| «This request was blocked by Gemini's filters. They can occasionally trigger by mistake on safe coding, security, or biology-related queries…» | Блокировка по правилам контента с прямым признанием ложных срабатываний | Строка, о которой сообщают пользователи инструментов на базе Gemini; к конкретному продукту она не привязана | Переформулировать, отправить отзыв |
| «Gemini недоступен в вашей стране», «User location is not supported» | Региональное ограничение | Приложение Gemini, Google AI Studio, Gemini API | Другая проблема; к содержанию запроса не относится |
HTTP 429 rate_limit_exceeded | Исчерпан лимит запросов | Gemini API | Ждать или повышать квоту; содержание запроса ни при чём |
Отдельное подтверждение: 7 июля 2026 года разработчик с включённой оплатой получил HTTP 400 «Input blocked: The prompt could not be submitted…» на модели предварительного доступа и решил, что у него нет прав на модель. Ответ на форуме разработчиков Google от 8 июля 2026 года: ошибка означает, что фильтр безопасности блокирует именно содержание запроса, а не что аккаунт не подходит для модели. Аккаунт от такой ошибки не блокируется и не ограничивается.
«The prompt could not be submitted»: запрос отклонён до того, как его увидела модель
The prompt could not be submitted. The prompt contains sensitive words that violate Google's Generative AI Prohibited Use Policy. Try rephrasing the prompt. If you think this was an error, send feedback.
Эта строка означает, что весь запрос — текст, вложенные изображения, история чата и системные инструкции — отклонён на входе, и модель не сгенерировала ни одного кандидата ответа. В Gemini API такой случай виден в поле promptFeedback.blockReason (кандидатов в ответе нет); по сообщениям разработчиков на форуме Google за июнь–июль 2026 года сама строка приходит в promptFeedback.blockReasonMessage, а SDK google-genai показывает её как HTTP 400 invalid_request с текстом «Input blocked: …». В Google AI Studio показывается та же английская строка, часто со ссылками на правила и на страницу устранения неполадок.
Слово «words» в сообщении вводит в заблуждение. Блокировка на входе с кодом PROHIBITED_CONTENT срабатывает на смысл фрагмента в контексте, а не на список слов. Пример с форума разработчиков Google от 14 сентября 2026 года: агент кодирования на gemini-3.8-flash получил эту строку на сводке тестов, где встречались «adversarial mutation testing», тестовые случаи с внедрением <script> и «mutant killers» — обычная лексика защитного тестирования. Официального ответа в ветке нет; совет из сообщества «отключить настройки безопасности или заменить слова заполнителями» к этому коду не применяется, потому что порог блокировки на PROHIBITED_CONTENT не влияет.
Практическое следствие: если запрос большой (вставленный документ, длинная переписка, изображение), триггер чаще всего лежит не в вашей последней фразе, а в чём-то «закопанном» внутри — именно такую проверку советовал ответ на форуме 8 июля 2026 года. Порядок поиска описан в разделе про локализацию триггера.
«The model output could not be generated»: запрос прошёл, отклонён ответ
The model output could not be generated. This output contains sensitive words that violate Google's Generative AI Prohibited Use Policy. If you think this was an error, send feedback.
Здесь ситуация другая: запрос принят, модель начала генерировать, но результат отклонён проверкой на выходе. В Gemini API это код finishReason: PROHIBITED_CONTENT, а строка выше приходит в поле finishMessage; в приложении Gemini и Google AI Studio она показывается вместо ответа. По документации SDK на 30 сентября 2026 года при стриминге текст кандидата в таком случае пустой — если вы читаете поток и получаете пустой ответ без ошибки, проверьте finishReason последнего фрагмента.
Разница важна для действий. Раз запрос прошёл, дело не в вашей формулировке как таковой, а в том, куда модель «повела» ответ. Обычно помогает сузить задачу: указать жанр и границы результата, убрать двусмысленность («опиши сцену» превращается в «опиши интерьер комнаты и освещение, без персонажей»), явно назвать возраст персонажей как совершеннолетний, если сцена вообще допускает интимный или конфликтный контекст. Если после сужения запроса ответ отклоняется снова, значит сама тема ведёт к запрещённому результату — раздел о правилах в конце описывает, где именно граница.
«This request was blocked by Gemini's filters»: та же блокировка, признающая ложные срабатывания
This request was blocked by Gemini's filters. They can occasionally trigger by mistake on safe coding, security, or biology-related queries. Please try rephrasing your prompt. You can send feedback or read more about our policies here.
Эту строку пользователи приводят наряду с двумя предыдущими; к какому именно интерфейсу она относится, в документации Google не записано, поэтому её стоит воспринимать как ещё одну формулировку той же блокировки по правилам контента, а не как признак отдельного продукта. Сама фраза полезна тем, что Google в ней прямо называет области ложных срабатываний: безопасный код, информационная безопасность, биология. Если ваш запрос из этих областей — тестирование уязвимостей своей системы, разбор вредоносного кода в учебных целях, работа с медицинской или биологической терминологией, — действия те же, что для первой строки: найти фрагмент-триггер, переписать его нейтрально по форме при том же содержании и отправить отзыв. Ссылка «send feedback» в самом сообщении — канал, который Google предлагает для сообщений о ложных срабатываниях.
Коды блокировки: что регулируется настройками безопасности, а что нет
Правило одно: настройки безопасности Gemini API действуют только на код SAFETY. Все остальные коды блокировки относятся к слою, который порогом не регулируется. Значения ниже — формулировки Google из справочника Gemini API и SDK google-genai по состоянию на 30 сентября 2026 года; перевод дан для понимания, в ответах API приходят английские коды.
| Код | Где приходит | Формулировка Google (перевод) | Реагирует на настройки безопасности |
|---|---|---|---|
SAFETY | promptFeedback.blockReason или finishReason | «The prompt was blocked for safety reasons» / при генерации — контент потенциально содержит нарушения безопасности; при стриминге текст пустой | Да — четыре регулируемые категории |
PROHIBITED_CONTENT | blockReason или finishReason | «The prompt was blocked because it contains prohibited content» — запрос или ответ содержит запрещённый контент | Нет |
BLOCKLIST | blockReason или finishReason | Запрос содержит термин из списка запрещённых терминов (blocklist); при генерации — «contains forbidden terms» | Нет |
OTHER | blockReason | Блокировка «may be due to the prompt's language, or because it contains other harmful content»; по документации устранения неполадок — запрос может противоречить условиям использования или не поддерживаться | Нет |
SPII | finishReason | Ограничения на конфиденциальные персональные данные | Нет |
RECITATION | finishReason | Ответ слишком близко воспроизводит существующий материал; совет Google — сделать запрос уникальнее и повысить temperature | Нет (это не фильтр контента) |
IMAGE_SAFETY | blockReason или finishReason | Запрос небезопасен для генерации изображений / у сгенерированных изображений есть нарушения безопасности | Нет |
IMAGE_PROHIBITED_CONTENT | finishReason | «Image generation stopped because the generated images have prohibited content» | Нет |
NO_IMAGE | finishReason | Ожидалось изображение, но оно не сгенерировано | Нет |
На странице кодов ошибок Gemini API те же причины перечислены в нижнем регистре — safety, prohibited_content, blocklist, spii, image_safety, image_prohibited_content, recitation, language, no_image — с короткими пояснениями вида «Prohibited content guidelines blocked the request» (по состоянию на 30 сентября 2026 года). Если вы видите в логах шлюза или стороннего сервиса prohibited_content строчными буквами, это тот же код PROHIBITED_CONTENT.
Две детали документации, которые определяют диагноз на моделях Gemini 2.5 и 3:
- По состоянию на 30 сентября 2026 года документация настроек безопасности говорит: если порог не задан, для моделей Gemini 2.5 и 3 порог блокировки по умолчанию — Off. Значит, на этих моделях блокировка с кодом
SAFETYбез ваших явных настроек практически невозможна, и почти любая блокировка приходит из нерегулируемого слоя. - Там же: «The Gemini API has built-in protections against core harms, such as content that endangers child safety. These types of harm are always blocked and cannot be adjusted» — встроенная защита от базовых видов вреда всегда включена и не настраивается.
Из этого следует правило принятия решения. Если код SAFETY — проверьте, какой порог вы задали и в какой категории safetyRatings показывает MEDIUM или HIGH; здесь порог можно поднять, если контент допустим для вашего приложения. Если код PROHIBITED_CONTENT, BLOCKLIST, IMAGE_SAFETY или OTHER — настройки трогать бессмысленно, остаются локализация триггера, переформулировка и отзыв. Если по правилам запрещённого использования запрос недопустим — остановиться.
Почему не помог BLOCK_NONE и как задать настройки безопасности явно
BLOCK_NONE не помогает, потому что он относится только к четырём регулируемым категориям и коду SAFETY. По документации Gemini API на 30 сентября 2026 года эти категории такие: домогательства (Harassment — «негативные или вредные комментарии в адрес идентичности или защищённых признаков»), разжигание ненависти (Hate speech — «грубый, неуважительный или нецензурный контент»), сексуальный контент (Sexually explicit — «ссылки на сексуальные акты или иной непристойный контент») и опасный контент (Dangerous — «поощряет, облегчает или подстрекает к вредным действиям»). Пороги: OFF, BLOCK_NONE, BLOCK_ONLY_HIGH, BLOCK_MEDIUM_AND_ABOVE, BLOCK_LOW_AND_ABOVE; вероятность в safetyRatings — NEGLIGIBLE, LOW, MEDIUM, HIGH. Ничего из этого не касается PROHIBITED_CONTENT и встроенной защиты.
Явные настройки в коде всё равно нужны — не чтобы «пробить» блокировку, а чтобы код блокировки был однозначным и вы не спорили с фильтром вслепую. Минимальный пример на Python с SDK google-genai: пороги заданы явно, а blockReason и finishReason читаются и логируются отдельно.
hljs pythonfrom google import genai
from google.genai import errors, types
client = genai.Client() # ключ берётся из переменной окружения GEMINI_API_KEY
safety = [
types.SafetySetting(category="HARM_CATEGORY_HARASSMENT", threshold="BLOCK_ONLY_HIGH"),
types.SafetySetting(category="HARM_CATEGORY_HATE_SPEECH", threshold="BLOCK_ONLY_HIGH"),
types.SafetySetting(category="HARM_CATEGORY_SEXUALLY_EXPLICIT", threshold="BLOCK_MEDIUM_AND_ABOVE"),
types.SafetySetting(category="HARM_CATEGORY_DANGEROUS_CONTENT", threshold="BLOCK_ONLY_HIGH"),
]
def ask(prompt: str) -> None:
try:
response = client.models.generate_content(
model="gemini-2.5-flash",
contents=prompt,
config=types.GenerateContentConfig(safety_settings=safety),
)
except errors.ClientError as exc:
# SDK может показать блокировку на входе как HTTP 400 "Input blocked: ..."
print("HTTP-ошибка:", exc)
return
feedback = response.prompt_feedback
if feedback and feedback.block_reason:
# Запрос отклонён до генерации: кандидатов нет.
print("blockReason:", feedback.block_reason, "|", feedback.block_reason_message)
return
candidate = response.candidates[0]
if candidate.finish_reason == "STOP":
print(response.text)
else:
# Ответ отклонён на выходе: SAFETY, PROHIBITED_CONTENT, BLOCKLIST, RECITATION...
print("finishReason:", candidate.finish_reason)
print("safetyRatings:", candidate.safety_ratings)
Логировать стоит три вещи вместе: итоговый текст запроса, который реально ушёл в API (после подстановки истории и системных инструкций), значение blockReason или finishReason и safetyRatings. Без этого при разборе жалобы пользователя невозможно понять, сработал регулируемый слой или нет.
Как найти фрагмент-триггер: пошаговая процедура
Локализация триггера — единственный способ отличить ложное срабатывание от запроса, который действительно нарушает правила. Повторная отправка того же текста обычно даёт тот же результат: решение принимается по содержанию, а не по времени или очереди.
- Отправьте минимальный запрос — одну фразу с задачей, без вложений, истории и системных инструкций. Если прошла, триггер в том, что вы убрали.
- Возвращайте фрагменты по одному: сначала системные инструкции, потом историю чата, потом вставленный документ или изображение. Первый фрагмент, после которого запрос снова отклонён, — и есть триггер. В длинной переписке триггером бывает сообщение из середины диалога, а не последняя реплика.
- Внутри найденного фрагмента проверьте типичные сочетания: слова с неоднозначным возрастом («девочка», «girl», «teen», «школьница») рядом с интимным, романтическим или насильственным контекстом; имена реальных людей в таких же сценах; подробное описание ран и крови; инструкции по незаконным действиям; персональные данные (паспорта, адреса, номера); вставленный чужой материал — переписка, комментарии, тексты песен.
- Перепишите фрагмент под нужный итоговый результат, а не «в обход». Полезные приёмы: назвать возраст персонажей явно совершеннолетним, если сцена вообще требует возраста; заменить конфликт описанием последствий, если сама сцена насилия не нужна; в запросах по безопасности и медицине описать цель («тест-кейсы для проверки экранирования пользовательского ввода») вместо голых терминов.
- Отправьте отзыв по ссылке из сообщения, если фрагмент легитимен, а блокировка повторяется. Это канал, который Google сам называет в сообщении; отзыв не разблокирует запрос сразу.
- Остановитесь, если найденный фрагмент — сексуальный контент, несовершеннолетние, реальные люди в интимных или насильственных сценах или попытка обойти фильтр. Блокировка сработала по правилам, и переформулировка здесь — уже нарушение.
При редактировании изображений порядок другой, потому что триггером чаще оказывается само загруженное изображение, а не текст. Проверьте четыре комбинации:
| Комбинация | Изображение | Запрос | Что означает блокировка |
|---|---|---|---|
| 1 | Исходное | Исходный | Стартовая точка: отклоняется |
| 2 | Исходное | Короткий нейтральный («сделай фон светлее») | Если отклоняется — триггер в изображении |
| 3 | Нейтральное (пейзаж, предмет) | Исходный | Если отклоняется — триггер в тексте запроса |
| 4 | Нейтральное | Короткий нейтральный | Если отклоняется — проблема не в контенте: модель, ключ, формат файла |
Редактирование фото с людьми: почему отклоняется безобидная правка
При работе с изображениями к проверке текста добавляется проверка самого изображения, и это чаще всего объясняет отклонённые правки. По документации Gemini API на 30 сентября 2026 года встроенная защита всегда блокирует контент, угрожающий детской безопасности, и не настраивается; при генерации изображений блокировка приходит кодами IMAGE_SAFETY, IMAGE_PROHIBITED_CONTENT или NO_IMAGE (модель должна была вернуть изображение, но не вернула). На фото с ребёнком могут отклонить даже просьбу «убрать фон» — не потому что правка вредна, а потому что защита оценивает изображение, а не намерение.
Что именно ищут фильтры изображений Google, видно по категориям фильтра безопасности Imagen на Vertex AI (страница обновлена 24 сентября 2026 года): дети, знаменитости, «знаменитость или ребёнок», люди и лица, персональные данные, сексуальный контент, насилие, опасный контент, ненависть, токсичность, вульгарность, сторонний контент, запрещённый контент. Это другой продукт Google с собственными кодами поддержки, и на Gemini API его коды не приходят, но набор категорий показывает логику: реальные лица, дети и узнаваемые люди — отдельные категории проверки, а не частный случай «сексуального контента». Что ложные срабатывания на детской безопасности реальны, подтверждает пример из соседней линейки: 13 марта 2026 года на форуме разработчиков Google описана безобидная коммерческая раскадровка (storyboard) в Veo 3.1, которую фильтр детской безопасности блокировал даже после удаления всех упоминаний детей.
Для легитимных правок это даёт три практических вывода:
- Вложенное фото с ребёнком или с узнаваемым реальным человеком — заведомый кандидат на триггер по комбинации 2 из таблицы выше. Уточнение текста не поможет; поможет другое исходное изображение или другой инструмент.
- Правила использования моделей изображений Gemini API требуют иметь права на загружаемые изображения и запрещают генерировать контент, который обманывает, преследует или вредит другим (документация генерации изображений по состоянию на 30 сентября 2026 года). Правка чужого фото без согласия человека — не «ложное срабатывание», даже если фильтр её пропустил.
- Если тест четырёх комбинаций показал, что триггер в тексте, а не в фото, и текст легитимен, переформулируйте под результат: «портрет в деловом костюме на нейтральном фоне» вместо описания внешности через тело.
Когда ложное срабатывание подтверждено тестом, а тот же запрос на моделях Gemini отклоняется снова, остаётся попробовать легитимный запрос на другой модели изображений. В браузерной студии YingTu это можно сделать со своим ключом LaoZhang API и оплатой за каждое изображение: GPT Image 2 VIP — $0,03 за изображение, Seedream 5.0 Flash — $0,018, а Nano Banana Pro (gemini-3-pro-image) — $0,09 по состоянию на 26 сентября 2026 года. Nano Banana Pro — та же модель Google, поэтому на неё действуют те же встроенные защиты; смысл теста именно в GPT Image 2 или Seedream. Студия тоже проверяет результат и отклоняет контент, нарушающий правила: это способ проверить легитимный запрос на другом фильтре, а не способ получить то, что Google блокирует по правилам.
Что запрещено правилами и где остановиться
Официальное название документа на русском — «Правила в отношении запрещенного использования генеративного искусственного интеллекта» (дата последнего изменения — 17 декабря 2024 года). Правила действуют на все генеративные продукты Google: приложение Gemini, Google AI Studio, Gemini API. По состоянию на 30 сентября 2026 года среди запрещённого, в частности:
- сексуальное насилие над детьми и их эксплуатация в любой форме;
- контент, который «facilitates non-consensual intimate imagery» — интимные изображения без согласия изображённого;
- «Sexually explicit content — for example, content created for the purpose of pornography or sexual gratification» — сексуальный контент, созданный ради порнографии или сексуального удовлетворения;
- насильственный экстремизм, содействие самоповреждению, незаконная деятельность;
- нарушение приватности и интеллектуальной собственности, выдача себя за другое лицо «without explicit disclosure, in order to deceive»;
- разжигание ненависти и травля;
- «Circumventing safety filters» — в русской редакции правил соответствующий пункт звучит как «Обходу фильтров безопасности и средств защиты от злоупотреблений»: любая манипуляция моделью ради нарушения правил сама является нарушением.
Правила предусматривают исключения «based on educational, documentary, scientific, or artistic considerations, or where harms are outweighed by substantial benefits to the public» — образовательные, документальные, научные и художественные цели. Именно на это исключение опирается переформулировка легитимного запроса: описать цель и контекст — допустимо; замаскировать запрещённый результат — нет. Если после честной локализации триггера оказывается, что запрос попадает в список выше, дальше идти некуда: ни настройки безопасности, ни другая модель, ни другой сервис не являются решением, и на этом диагностика заканчивается.
Частые вопросы
Что значит prohibited_content в ответе Gemini API?
prohibited_content (в ответах API — PROHIBITED_CONTENT) означает, что запрос или сгенерированный ответ отклонён по правилам запрещённого контента Google; на странице кодов ошибок формулировка звучит как «Prohibited content guidelines blocked the request» (по состоянию на 30 сентября 2026 года). Если код пришёл в promptFeedback.blockReason, отклонён запрос и кандидатов нет; если в finishReason — отклонён ответ. Настройками безопасности этот код не регулируется.
Ограничен ли мой аккаунт или ключ после такой ошибки?
Нет. Строка «The prompt could not be submitted…» и HTTP 400 «Input blocked» относятся к конкретному запросу, а не к аккаунту, ключу или доступу к модели — так на форуме разработчиков Google 8 июля 2026 года ответили разработчику, который принял эту ошибку за отсутствие доступа к модели. Следующий запрос с другим содержанием обрабатывается как обычно.
Почему безобидная правка фотографии отклоняется, хотя текст запроса нейтральный?
Потому что фильтр оценивает изображение вместе с текстом, и триггером чаще всего оказывается фото: ребёнок, узнаваемый реальный человек, крупное лицо. Проверьте это комбинацией «исходное фото + короткий нейтральный запрос» из таблицы четырёх комбинаций: если и она отклоняется, дело в изображении, и текст менять бесполезно.
Что означает blockReason OTHER?
По документации Gemini API на 30 сентября 2026 года OTHER означает блокировку по неуточнённой причине: из-за языка запроса, из-за другого вредного контента или потому что запрос противоречит условиям использования либо не поддерживается. Действия те же, что для PROHIBITED_CONTENT: минимальный запрос, возврат фрагментов, переформулировка; настройки безопасности на OTHER не влияют.