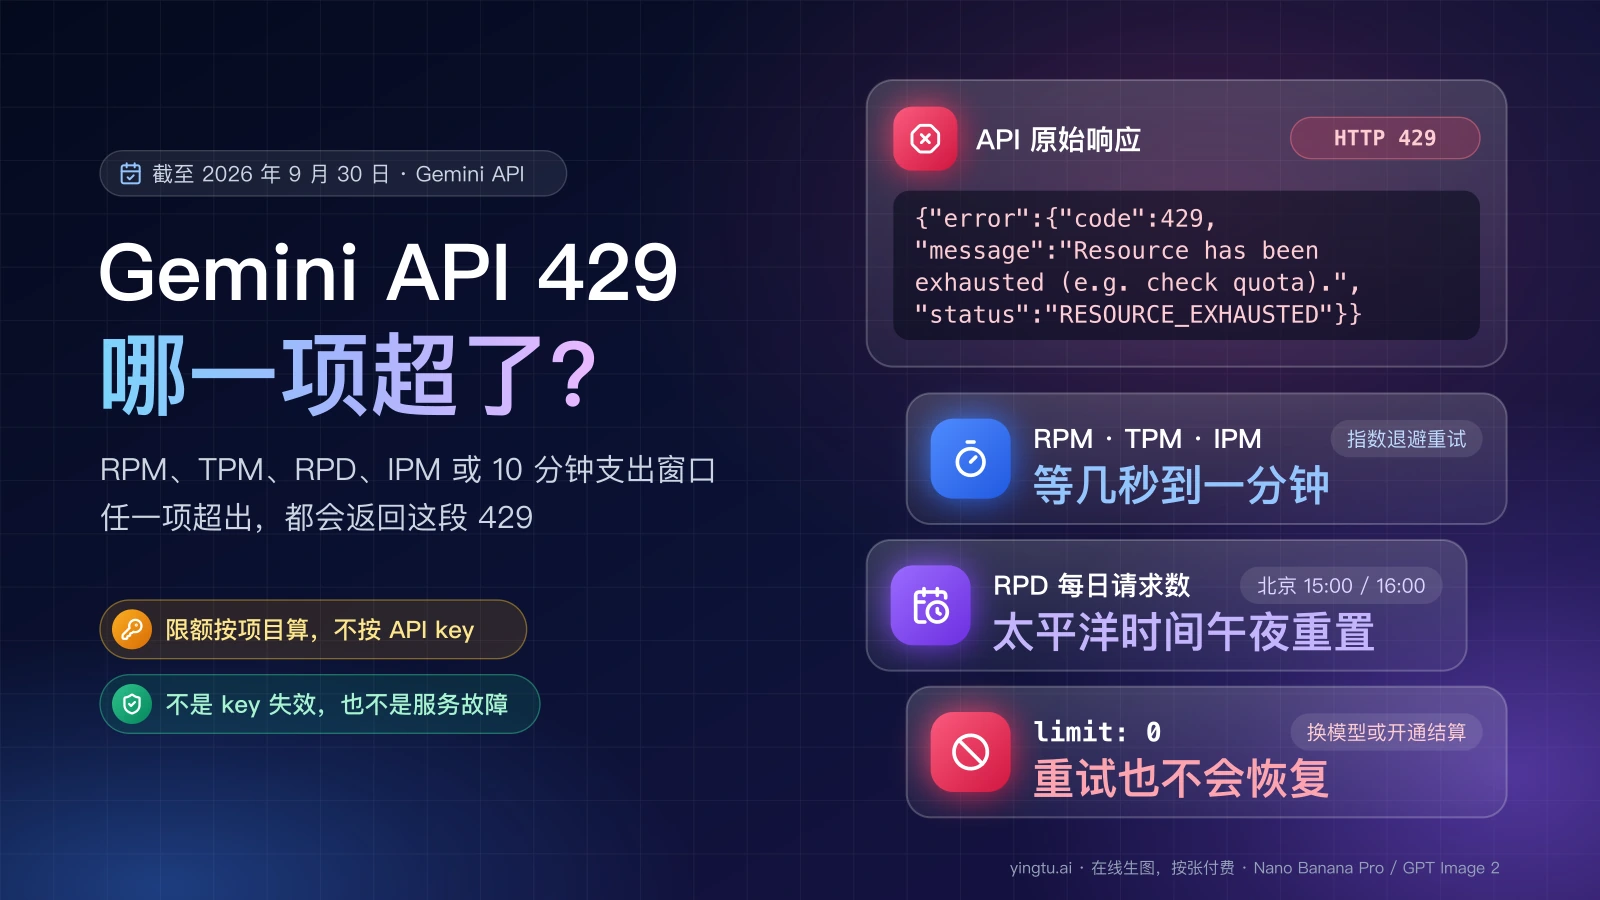
hljs json{"error":{"code":429,"message":"Resource has been exhausted (e.g. check quota).","status":"RESOURCE_EXHAUSTED"}}
Gemini API 返回这段 429 RESOURCE_EXHAUSTED,意思是你的项目在每分钟请求数(RPM)、每分钟 token 数(TPM)、每日请求数(RPD)、每分钟图片数(IPM)或 10 分钟支出窗口中,至少有一项超出了限额。它不代表 API key 失效,也不代表服务故障;怎么处理取决于超的是哪一项:每分钟的限额等一会儿、用指数退避重试就能恢复,每日请求数要等太平洋时间午夜重置,错误里出现 limit: 0 则说明这个模型对你的项目根本没有免费额度,重试多少次都不会成功。
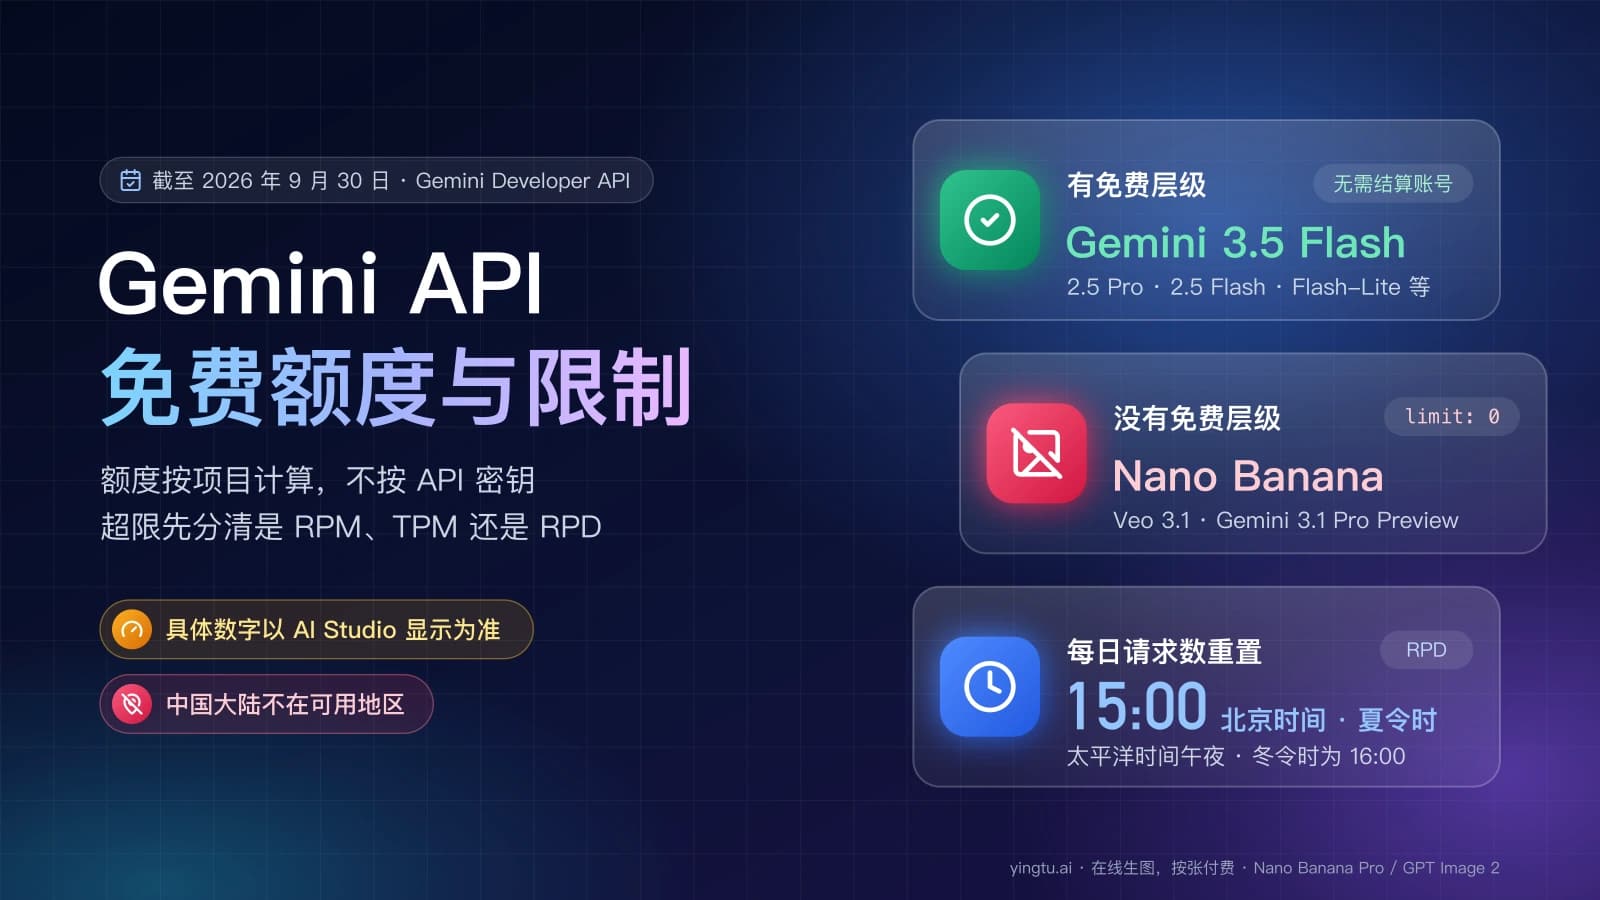
截至 2026 年 9 月 30 日,Google 的速率限制文档只说明限额的计算方式和层级,不再列出每个模型的具体数字;你的项目实际能用多少,要在 AI Studio 的速率限制页里看。另外要记住一点:限额按项目计算,不按 API key 计算。
429 RESOURCE_EXHAUSTED 对应的限额:RPM、TPM、RPD、IPM 与支出窗口
Gemini API 同时用几项限额约束一个项目,任何一项超出都会返回 429 RESOURCE_EXHAUSTED,所以先弄清每一项在数什么、什么时候恢复:
| 限额(截至 2026 年 9 月 30 日,Google 速率限制文档) | 计的是什么 | 什么时候恢复 | 超了怎么办 |
|---|---|---|---|
| RPM(每分钟请求数) | 每分钟的调用次数,长短请求都算 1 次 | 按分钟计算,等待片刻即可 | 指数退避重试,降低并发 |
| TPM(每分钟 token 数) | 每分钟的输入 token 数 | 按分钟计算,等待片刻即可 | 缩短上下文、拆分长文档,再退避重试 |
| RPD(每日请求数) | 一天内的调用次数 | 太平洋时间午夜重置 | 等重置,或换一个仍有余量的模型 |
| IPM(每分钟图片数) | 图片生成模型每分钟产出的图片数 | 按分钟计算 | 放慢出图节奏,退避重试 |
| TPD(每日 token 数) | 部分模型才有的每日 token 上限 | 按天计算,以 AI Studio 显示为准 | 等次日,或换模型 |
| 10 分钟支出窗口 | 付费层级在滚动 10 分钟内产生的费用:Tier 1 为 $10,Tier 2 为 $50,Tier 3 为 $200 | 最多等 10 分钟 | 等窗口滑过,或升级层级 |
几条容易误解的地方:
- TPM 只算输入 token。一次塞进整本文档的请求可能单独就占掉大半 TPM,所以常见的情况是请求次数远没到 RPM,却已经被 429。
- 日志或提示里写 "rpm exhausted",指的就是 RPM 这一项用完了,属于最容易恢复的一类。
- 预览版和实验性模型的限额比正式版更紧;Google 也写明这些限额不作保证,实际容量可能浮动。
- RPD 的重置时刻换成北京时间:美国夏令时期间是 15:00,2026 年 11 月 1 日美国结束夏令时后是 16:00。
先判断是哪一项超了:四步定位
- 打开 AI Studio 速率限制页。 选中报错的项目,看各模型的 RPM、TPM、RPD 用量,哪一项接近或达到上限,就是它。用量可以按最近 28 天查看。
- 读错误消息里的细节。 有的 429 消息会带上配额名称和数值。看到
limit: 0,说明这个模型在你的项目上额度为零,常见于没有免费层级的模型:截至 2026 年 9 月 30 日,Nano Banana 2、Nano Banana Pro、Veo 3.1、Gemini 3.1 Pro Preview 在免费层级都不可用。哪些模型免费、免费额度怎么算,见《Gemini API 免费额度与限制:哪些模型免费,超限怎么办》。 - 按维度决定动作:
- 如果是 RPM、TPM 或 IPM,就用指数退避重试,同时降低并发或缩短输入;
- 如果是 RPD 或 TPD,就停止重试,等重置,或换一个在速率限制页上仍有余量的模型;
- 如果是 10 分钟支出窗口,就等最多 10 分钟,长期不够用再升级层级;
- 如果是
limit: 0,就换一个有免费层级的模型,或者给项目开通结算。
- 排除无效做法。 同一个项目里多建几个 API key 没有用,它们共享同一份限额。重试也要有上限:429 连续出现几分钟都不消失,基本可以断定是每日限额或支出窗口,而不是每分钟限额。
同一个报错的其他写法
Resource has been exhausted (e.g. check quota). 在不同工具里外壳不同,本质都是上面那张表里的某一项超限:
| 你看到的字符串 | 出现的地方 | 含义 |
|---|---|---|
{"error":{"code":429,"message":"Resource has been exhausted (e.g. check quota).","status":"RESOURCE_EXHAUSTED"}} | 直接调用 REST 接口或 SDK 抛出的原始响应 | 项目某一项限额超出 |
error: RetriableError: [RESOURCE_EXHAUSTED] | 部分客户端和框架的封装 | 同上;"Retriable" 只表示可以重试,每日限额用完时重试也不会成功 |
[API Error: Resource has been exhausted (e.g. check quota).] | Gemini CLI | 同上,额度来自 CLI 所用的项目 |
Google 的错误代码文档把 429 描述为 "You have exceeded the per-minute or per-second request or token limit.",给出的对策是 "Wait and retry with exponential backoff."。这条对策针对的是每分钟一类的限额;对每日限额和 limit: 0 并不适用。
用指数退避重试:Python 示例
Google 的问题排查文档建议对 429、408 和 5xx 这类暂时性错误做指数退避重试,对 400、402、403 这类客户端错误不要重试。下面是一个基于 google-genai SDK 的简短示例,API key 从环境变量 GEMINI_API_KEY 读取,不要写进代码:
hljs python# 示例:只对暂时性错误做指数退避重试
from random import uniform
from time import sleep
from google import genai
from google.genai import errors
client = genai.Client() # 从环境变量 GEMINI_API_KEY 读取 key
def is_retryable(e: errors.APIError) -> bool:
if "limit: 0" in str(e): # 模型在本项目没有额度,重试无意义
return False
return e.code in (408, 429) or 500 <= e.code < 600
def generate_with_backoff(prompt, model="gemini-2.5-flash", max_attempts=5):
for attempt in range(max_attempts):
try:
return client.models.generate_content(model=model, contents=prompt)
except errors.APIError as e:
if not is_retryable(e) or attempt == max_attempts - 1:
raise
delay = min(2 ** attempt, 32) + uniform(0, 1) # 1、2、4、8 秒……加随机抖动
sleep(delay)
这段代码做了三件事:只重试暂时性错误;遇到 limit: 0 立即抛出;等待时间按 1、2、4、8 秒翻倍并加随机抖动,避免多个进程在同一时刻一起重试。5 次都失败时它会把错误抛出来,这时候应该回到 AI Studio 速率限制页查看是不是每日限额用完了,而不是继续加大重试次数。
AI Studio key、Vertex AI、Gemini CLI:额度不是同一套
同样的 RESOURCE_EXHAUSTED,来源可能是三套不同的额度:
- AI Studio 的 API key(Gemini Developer API):限额跟着 key 所在项目的层级走,就是前面表格说的 RPM、TPM、RPD 等,在 AI Studio 速率限制页查看。
- Vertex AI:使用 Google Cloud 自己的配额体系,和 AI Studio 的限额互不相通。在 Vertex AI 上遇到 429,按 Google Cloud 的 Error code 429 页面处理,不要套用 AI Studio 的层级规则。
- Gemini CLI:报错字符串和 API 一样。用 AI Studio 的 API key 运行时,CLI 消耗的是这个 key 所在项目的额度,和你自己写代码调用共用同一份 RPD;免费项目上多开几轮对话,也可能很快碰到每日上限。
层级、提额与 Batch API
项目的限额取决于它所在的使用层级。截至 2026 年 9 月 30 日,Google 速率限制文档列出的层级如下:
| 层级 | 资格条件 | 层级支出上限 |
|---|---|---|
| Free | 有一个活跃项目或处于免费试用 | 不适用 |
| Tier 1 | 项目关联了有效的结算账号 | $250 |
| Tier 2 | 累计付费满 $100,且已过 3 天 | $2,000 |
| Tier 3 | 累计付费满 $1,000,且已过 30 天 | $20,000 至 $100,000 以上 |
提额的正规路线有这几条:
- 从 Free 升到 Tier 1:在 AI Studio 的 API keys 或 Projects 页面点 "Set up billing",关联结算账号;预付的最低充值额是 $5(截至 2026 年 9 月 30 日,结算文档)。
- 升到 Tier 2、Tier 3:满足上表的累计付费和天数后自动升级。
- 付费层级仍不够用:速率限制文档里有申请更高限额的表单入口。
- 大批量、不着急要结果的任务:改用 Batch API。它的限额和实时接口分开计算(最多 100 个并发批处理请求,单个输入文件 2 GB,存储 20 GB)。
- 控制花费:可以在 AI Studio 给项目设置项目级支出上限(spend cap)。上限设得太低,也会让本来正常的调用停下来,排查时一并检查。
如果你的调用量确实超出当前层级、升级又需要等待,LaoZhang API 是另一条路线:它以 Gemini 原生格式和 OpenAI 兼容格式提供 Gemini 模型,按 token 或按次计费。它不是 Google 官方服务,额度与你的 Google 项目是两套独立体系,适合需要更多余量、又能接受第三方网关的开发者。
别和这些错误混淆
同样是请求失败,下面几种不是限额问题,退避重试也解决不了(截至 2026 年 9 月 30 日,Google 错误代码与结算文档):
| 状态码 | 含义 | 处理 |
|---|---|---|
429 RESOURCE_EXHAUSTED | 某一项限额超出 | 按上文定位维度 |
| 402 Payment Required | 预付余额降到 $0,关联到该结算账号的所有项目的 key 同时停用 | 充值后恢复 |
403 PERMISSION_DENIED | API key 没有权限或配置不对 | 检查 key 和项目设置 |
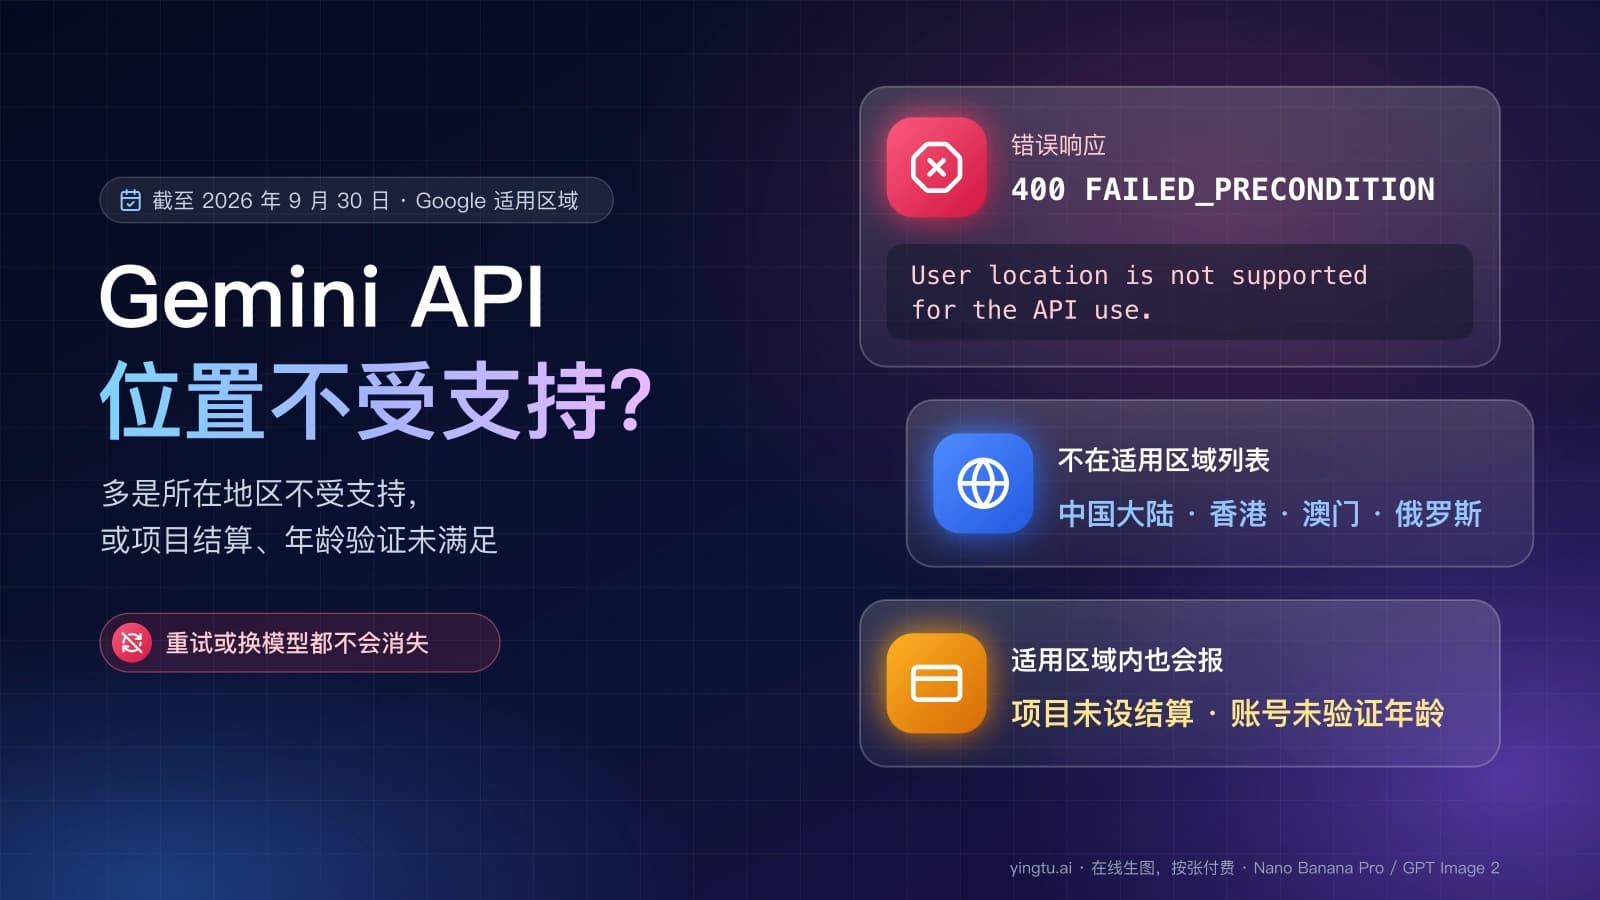
400 FAILED_PRECONDITION | 前置条件不满足,例如结算未启用 | 在 AI Studio 开通或修复结算 |
常见问题
Gemini API 的 429 多久能恢复?
每分钟一类的限额(RPM、TPM、IPM)通常等几秒到一分钟就能恢复;10 分钟支出窗口最多等 10 分钟;每日请求数要等太平洋时间午夜重置,也就是北京时间 15:00(美国夏令时期间)或 16:00(2026 年 11 月 1 日之后)。limit: 0 不会自己恢复,需要换模型或开通结算。
请求次数没到 RPM,为什么也报 429?
最常见的原因是 TPM:它只算输入 token,长上下文请求几次就能把一分钟的额度用完。其次是 IPM(图片模型)、每日请求数,以及付费项目的 10 分钟支出窗口。预览版模型的限额更紧,也更容易撞上。
多建几个 API key 能提高额度吗?
不能。Google 写明限额按项目计算,不按 API key 计算,同一项目下的所有 key 共用一份限额。想要更多额度,正规办法是升级层级、申请提额或把非实时任务改到 Batch API。
为什么以前能正常调用,最近免费项目经常 429?
免费层级的额度会调整。2025 年 12 月,Reddit 和 Google AI 开发者论坛上就有不少用户报告免费项目突然持续 429,时间与 Google 下调免费额度吻合。遇到这种情况,以 AI Studio 速率限制页上显示的当前数字为准。
用 Vertex AI 也是看 AI Studio 的速率限制页吗?
不是。Vertex AI 用 Google Cloud 的配额体系,AI Studio 速率限制页只反映 Gemini Developer API 的用量。Vertex AI 上的 429 请按 Google Cloud 的 Error code 429 页面处理。