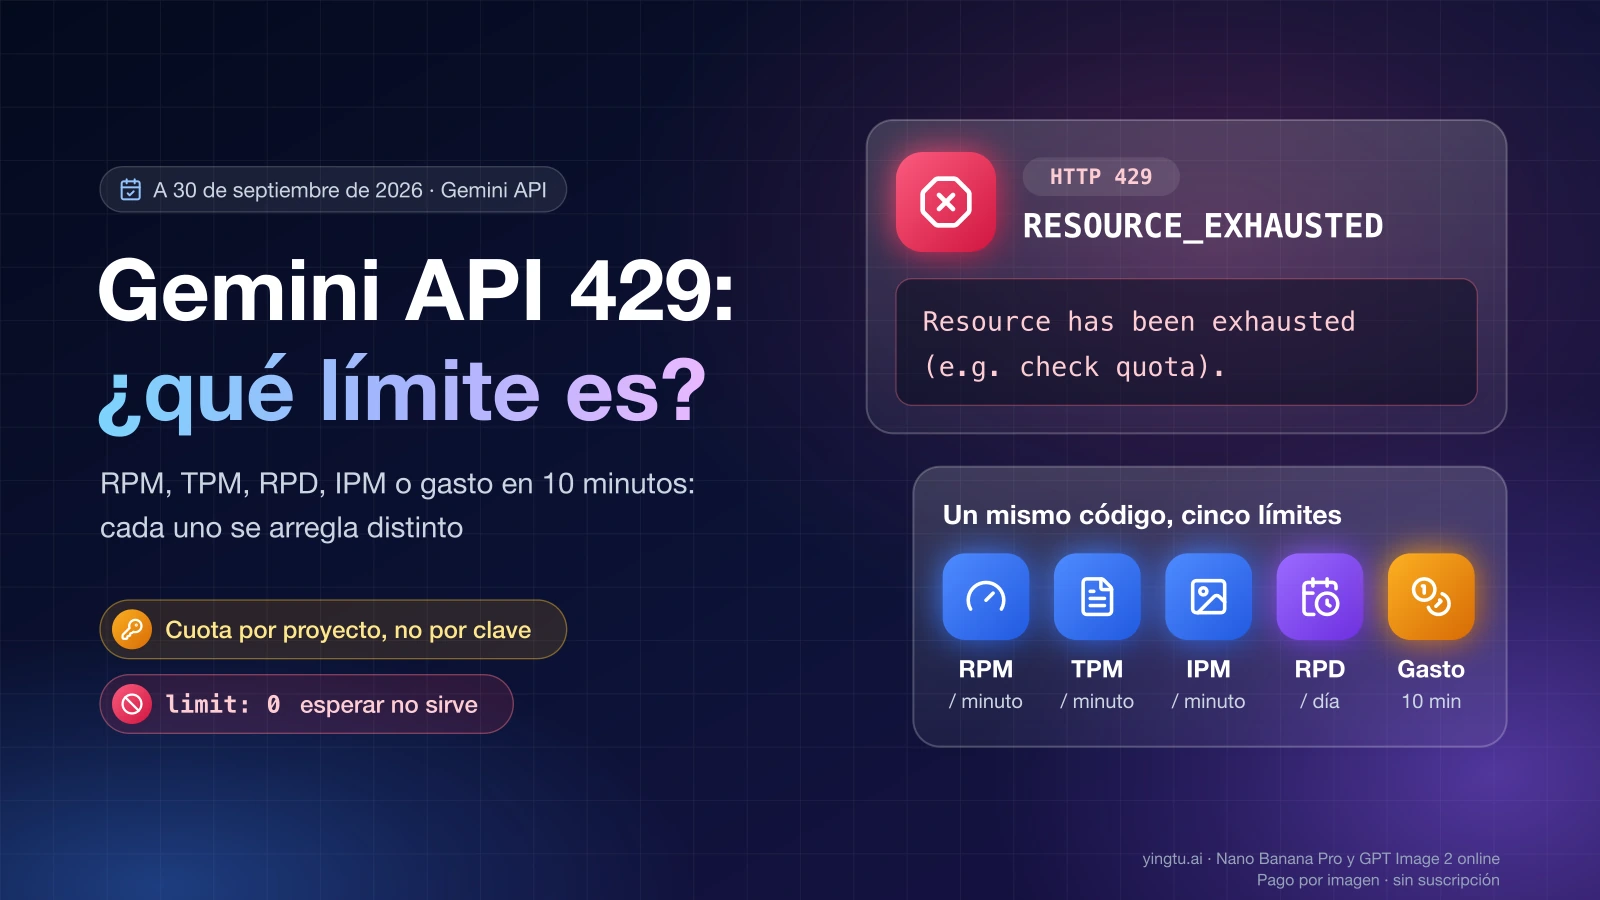
«Resource has been exhausted (e.g. check quota).», con código 429 y estado RESOURCE_EXHAUSTED, es la forma en que la API de Gemini te dice que tu proyecto ha superado uno de sus límites de uso. La respuesta completa suele tener este aspecto:
hljs json{"error":{"code":429,"message":"Resource has been exhausted (e.g. check quota).","status":"RESOURCE_EXHAUSTED"}}
El límite superado puede ser de solicitudes por minuto (RPM), tokens de entrada por minuto (TPM), solicitudes por día (RPD), imágenes por minuto (IPM) o, en proyectos de pago, el gasto acumulado en una ventana de 10 minutos. La solución depende de cuál sea: un pico por minuto se arregla reintentando con espera exponencial; la cuota diaria, esperando al reinicio o cambiando de modelo; y si el detalle del error dice limit: 0, ese modelo no tiene nivel gratuito en tu proyecto y esperar no sirve de nada. Todas las cifras son a 30 de septiembre de 2026, según la documentación de límites de frecuencia de Google.
Qué cuenta cada límite de la API de Gemini y cuándo se libera
Google evalúa tu uso contra cada límite por separado, y superar cualquiera de ellos basta para recibir el 429. Los límites se aplican por proyecto de Google Cloud, no por clave de API, y varían según el modelo y el nivel de uso del proyecto.
| Límite (a 30 de septiembre de 2026) | Qué cuenta | Cuándo vuelve a haber margen | Qué hacer si lo agotas |
|---|---|---|---|
| RPM | Solicitudes por minuto a un modelo | Al cabo de menos de un minuto | Reintentar con espera exponencial y reducir las llamadas simultáneas |
| TPM | Tokens de entrada por minuto | Al cabo de menos de un minuto | Acortar prompts, trocear documentos largos y espaciar las llamadas |
| RPD | Solicitudes por día a un modelo | A medianoche, hora del Pacífico (9:00 en la España peninsular casi todo el año) | Esperar al reinicio, pasar a otro modelo o activar la facturación |
| IPM | Imágenes por minuto, en modelos de imagen como Nano Banana | Al cabo de menos de un minuto | Espaciar las peticiones de imagen |
| TPD | Tokens por día, solo en algunos modelos | Es un tope diario; AI Studio indica si tu modelo lo tiene | Repartir el trabajo entre varios días |
| Gasto en 10 minutos | Dinero gastado en una ventana móvil de 10 minutos: 10 $ en Nivel 1, 50 $ en Nivel 2 y 200 $ en Nivel 3; no existe en el nivel gratuito | Como mucho, 10 minutos después | Esperar o repartir las llamadas caras en el tiempo |
El TPM cuenta los tokens que envías, no los que recibes. Por eso un proyecto puede tocar el TPM con muy pocas solicitudes si cada una lleva un PDF largo o un historial de conversación extenso, mientras el RPM sigue lejos del tope.
Que el límite sea por proyecto tiene una consecuencia práctica: todas las claves de un mismo proyecto comparten los mismos contadores. Si tu aplicación, un script de pruebas y la Gemini CLI usan claves del mismo proyecto, las tres gastan el mismo RPM y el mismo RPD. Crear una clave nueva dentro de ese proyecto no añade cuota.
Cómo saber qué límite has superado
El código 429 es el mismo para todos los casos, así que el diagnóstico sale de tres sitios:
- Abre la página de límites de Google AI Studio, elige el proyecto al que pertenece tu clave y busca la fila del modelo exacto que llamas (por ejemplo,
gemini-2.5-flash). Ahí ves los límites activos de ese modelo en tu proyecto y puedes compararlos con el ritmo real de tu código. - Lee el cuerpo completo del error, no solo el código. Cuando la respuesta trae detalle de cuota, nombra el límite (del tipo
GenerateContent request limit per …) y su valor enlimit:. - Fíjate en cuánto tarda en desaparecer: segundos, horas o nunca.
Con esas tres pistas, la decisión es directa:
- Si el 429 aparece tras una ráfaga de llamadas y desaparece en menos de un minuto, has tocado el RPM o el TPM. Añade espera exponencial (exponential backoff), baja la concurrencia y acorta las entradas.
- Si persiste durante horas y AI Studio muestra el RPD al tope, has agotado la cuota diaria. Espera al reinicio de medianoche del Pacífico, cambia a otro modelo que tenga cuota o activa la facturación. La documentación de errores da para este caso la misma salida: esperar al reinicio o pedir más cuota.
- Si el detalle dice
limit: 0, el modelo no tiene nivel gratuito en tu proyecto. A 30 de septiembre de 2026 es el caso de Nano Banana 2, Nano Banana Pro, Veo y Gemini 3.1 Pro Preview. Qué modelos sí son gratis y con qué cuotas lo tienes en Gemini API gratis: qué límites tiene y qué hacer al agotarlos. - Si el proyecto es de pago y el 429 llega después de varias llamadas caras seguidas, has tocado el límite de gasto de la ventana de 10 minutos. Espera, reparte las llamadas o sube de nivel.
- Si no encaja con nada, comprueba qué otras aplicaciones o herramientas usan claves del mismo proyecto.
Hay otros códigos que se confunden con el 429 y tienen otra causa. Un 503 UNAVAILABLE significa que el servicio está sobrecargado, no que tu cuota se haya acabado, y también se resuelve reintentando con espera exponencial. Un 402 Payment Required aparece cuando el saldo de prepago de la cuenta de facturación llega a 0 $, y afecta a todas las claves de todos los proyectos vinculados a esa cuenta. Un 400 FAILED_PRECONDITION puede indicar, por ejemplo, que la facturación está desactivada, y un 403 PERMISSION_DENIED, que la clave no tiene permiso para ese recurso.
Reintentar con espera exponencial, pero solo cuando sirve
Para el 429 por minuto, Google recomienda esperar y reintentar con espera exponencial: cada intento fallido duplica la pausa antes del siguiente. Reintentar solo tiene sentido si el límite se libera solo en poco tiempo, es decir, RPM, TPM, IPM, la ventana de gasto o un 503. Con limit: 0 o con el RPD agotado, cada reintento es una llamada más que vuelve a fallar.
Este ejemplo usa el SDK de Python google-genai y lee la clave de la variable de entorno GEMINI_API_KEY (o GOOGLE_API_KEY), nunca del código:
hljs python# Ejemplo: reintentos con espera exponencial para la API de Gemini
from random import uniform
from time import sleep
from google import genai
from google.genai import errors
client = genai.Client() # toma la clave de GEMINI_API_KEY o GOOGLE_API_KEY
def generar(prompt, modelo="gemini-2.5-flash", intentos=7):
for intento in range(intentos):
try:
return client.models.generate_content(model=modelo, contents=prompt)
except errors.APIError as e:
reintentable = e.code in (429, 503) and "limit: 0" not in str(e)
if not reintentable or intento == intentos - 1:
raise
espera = min(2 ** intento, 32) + uniform(0, 1)
print(f"{e.code} {e.status}: nuevo intento en {espera:.1f} s")
sleep(espera)
Las pausas son de 1, 2, 4, 8, 16 y 32 segundos más una fracción aleatoria: en total, algo más de un minuto, suficiente para que se libere un límite por minuto. Si después de eso sigue llegando el 429, casi seguro es el RPD, y el error sube a tu código en vez de alargar la espera. La fracción aleatoria evita que varios procesos que fallaron a la vez vuelvan a llamar en el mismo instante y provoquen otro 429. Si lanzas muchas peticiones en paralelo, limita cuántas van a la vez con una cola; reintentar no compensa una concurrencia mayor que tu RPM.
AI Studio, Vertex AI y Gemini CLI: el mismo mensaje, cuotas distintas
El texto «Resource has been exhausted» aparece en varias herramientas de Google, pero el contador que hay detrás depende de por dónde llamas a Gemini.
Clave de Google AI Studio
Es el caso más habitual: una clave de la API de Gemini creada en AI Studio gasta la cuota de su proyecto, que puedes ver en la página de límites de AI Studio. Los niveles de uso, la ventana de gasto y el reinicio a medianoche del Pacífico se aplican aquí.
Vertex AI
Si llamas a Gemini a través de Vertex AI en Google Cloud, el 429 procede de otro sistema de cuotas: los límites de AI Studio no se aplican y su página no los muestra. Google mantiene una página específica para el error 429 en Vertex AI, hoy dentro de la documentación de Gemini Enterprise Agent Platform, con sus propias opciones de consumo y reintentos; consúltala allí en lugar de aplicar las cifras de AI Studio.
Gemini CLI: [API Error: Resource has been exhausted (e.g. check quota).]
La Gemini CLI muestra el mismo error entre corchetes. Cuando la configuras con una clave de la API de Gemini, sus peticiones gastan la cuota del proyecto de esa clave: el mismo RPM y el mismo RPD que tu aplicación. Una sesión larga con la CLI puede dejar sin cuota diaria a un script que comparte proyecto, y al revés. En el repositorio de la CLI hay informes de usuarios que lo recibían muy pronto; en la incidencia #1848 de GitHub, del 26 de junio de 2025, uno lo describía tras solo tres prompts. Y desde diciembre de 2025, cuando Google redujo los límites del nivel gratuito, aparecieron en Reddit y en el foro de desarrolladores de Google informes de 429 persistentes en proyectos gratuitos.
Algunas herramientas envuelven el mismo fallo como error: RetriableError: [RESOURCE_EXHAUSTED]. Que lo marquen como reintentable no cambia nada: si el límite agotado es el RPD o el modelo tiene limit: 0, los reintentos automáticos solo repiten el error.
Cuando necesitas más margen: niveles, API Batch y topes de gasto
Si el 429 aparece con el uso normal y no solo en picos, el problema ya no está en el código sino en el nivel del proyecto. Los niveles de uso, a 30 de septiembre de 2026:
| Nivel | Requisito | Tope de gasto del nivel | Límite de gasto cada 10 minutos |
|---|---|---|---|
| Gratuito | Proyecto activo o prueba gratuita | No aplica | No aplica |
| Nivel 1 | Cuenta de facturación activa vinculada | 250 $ | 10 $ |
| Nivel 2 | 100 $ pagados y 3 días desde el primer pago | 2.000 $ | 50 $ |
| Nivel 3 | 1.000 $ pagados y 30 días desde el primer pago | 20.000–100.000 $ o más | 200 $ |
Vincular la facturación lleva el proyecto al Nivel 1; los siguientes se alcanzan al cumplir el gasto y los días de la tabla. Si en un nivel de pago necesitas límites por encima de los habituales, la documentación de límites enlaza un formulario para solicitarlos.
Para trabajos grandes que no necesitan respuesta inmediata (clasificar miles de textos, generar descripciones de un catálogo), la API Batch tiene límites propios, separados del RPM: 100 solicitudes por lotes simultáneas, archivos de entrada de hasta 2 GB y 20 GB de almacenamiento. Pasar ese volumen a lotes libera el RPM para las llamadas interactivas.
Hay un freno más que conviene revisar antes de tocar el código: el tope de gasto mensual del proyecto. Quien tenga rol de editor, propietario o administrador puede fijarlo en AI Studio, en la página Spend, dentro de Monthly spend cap > Edit spend cap. Según la documentación de facturación, al alcanzarlo Google pausa el servicio del proyecto, aunque las tareas largas en curso, como los lotes, pueden excederlo algo. Si tus llamadas se cortan tras un periodo de mucho gasto, mira primero ese tope.
Si ni el nivel ni la API Batch te dan el margen que necesitas, o prefieres pagar por uso a través de un intermediario, LaoZhang API sirve modelos Gemini en formato nativo y en formato compatible con OpenAI, con cobro por tokens o por llamada según el modelo (documentación). Sus límites son los de ese servicio, no los de tu proyecto de Google, y no es un canal oficial de Google, así que revisa sus condiciones antes de usarlo en producción.
Preguntas frecuentes
¿A qué hora se reinicia la cuota diaria de la API de Gemini en España?
A medianoche, hora del Pacífico, que en la España peninsular son las 9:00 casi todo el año. La excepción son los días en que Europa ya ha cambiado de hora y Estados Unidos todavía no: unas semanas de marzo y, en 2026, del 25 de octubre al 1 de noviembre, cuando el reinicio llega a las 8:00. En Canarias, siempre una hora antes que en la península. Los límites por minuto no esperan a esa hora: se liberan en menos de un minuto.
¿Me da más cuota crear otra clave de API?
No. Los límites de la API de Gemini se aplican por proyecto, no por clave, así que todas las claves de un proyecto comparten los mismos contadores de RPM, TPM y RPD. Para tener más margen hay que subir de nivel, repartir el trabajo en el tiempo o mover los trabajos grandes a la API Batch.
¿Por qué recibo un 429 si apenas he hecho llamadas?
Las causas más habituales son cuatro: el modelo tiene limit: 0 en tu proyecto porque no tiene nivel gratuito; pocas solicitudes con entradas muy largas han agotado el TPM; otra aplicación o la Gemini CLI comparte proyecto y ha gastado el RPD; o, en un proyecto de pago, unas pocas llamadas caras han superado el gasto permitido en 10 minutos. La página de límites de AI Studio y el detalle del error te dicen cuál de ellas es.