"The prompt could not be submitted. The prompt contains sensitive words that violate Google's Generative AI Prohibited Use Policy."는 Gemini가 요청을 처리하기 전에 내용을 판정해 거절했다는 콘텐츠 정책 차단 메시지입니다. 서버 과부하, 브라우저 캐시, 사용량 한도, 접속 지역, 계정 상태와는 관계가 없습니다. 시크릿 창을 열거나 캐시를 지우고 같은 요청을 다시 보내면 같은 결과가 나옵니다.
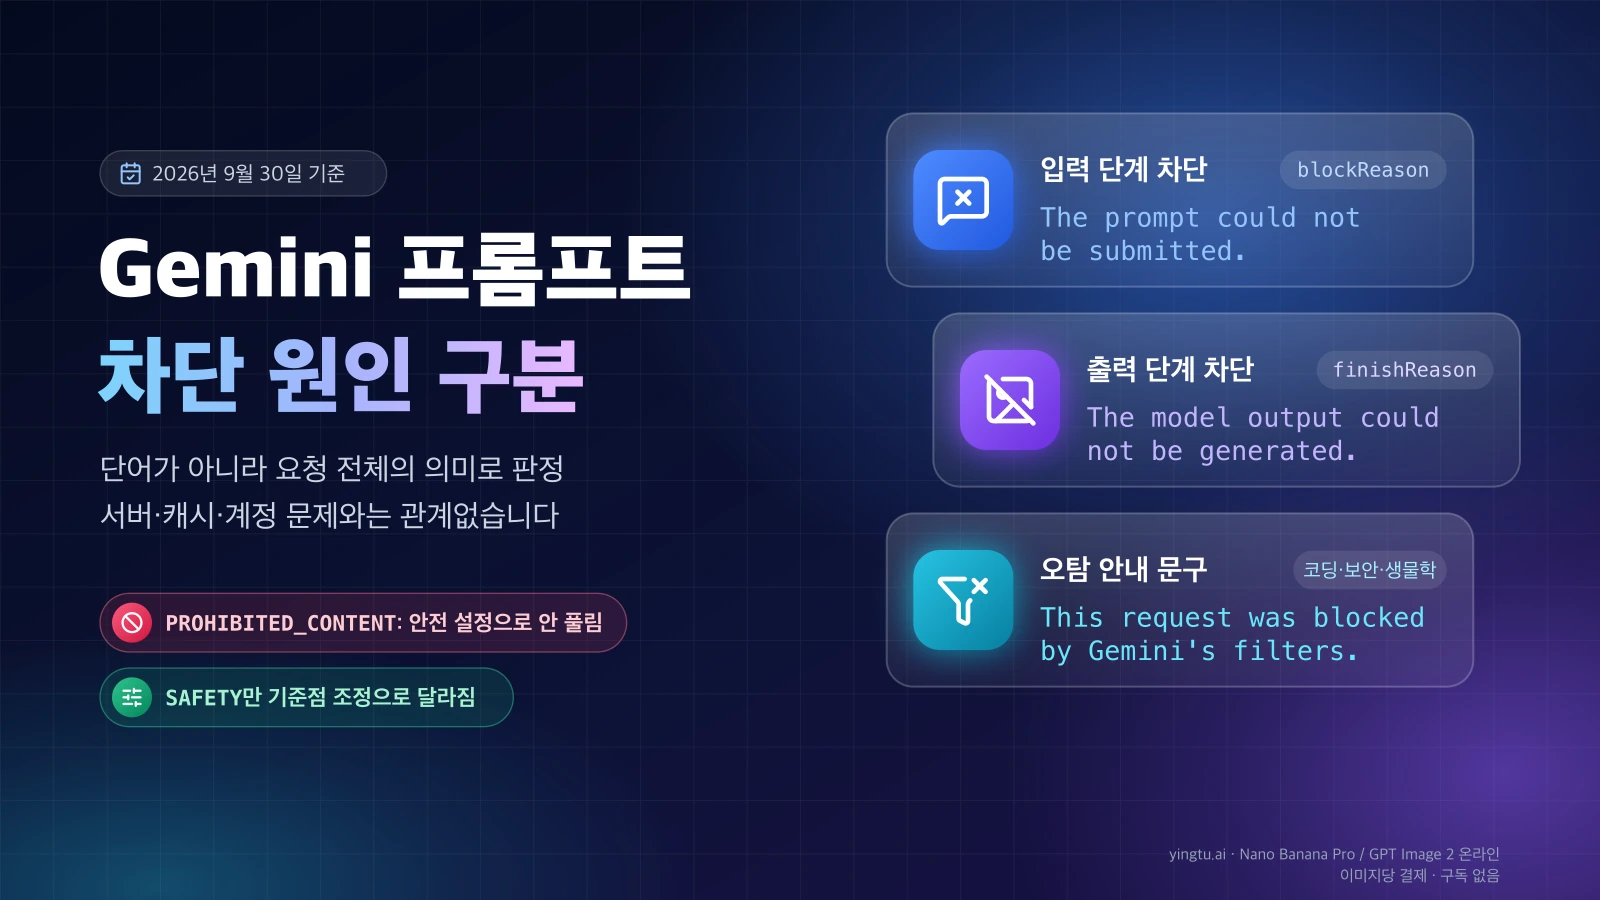
같은 계열의 문구는 세 가지이고, 나타나는 단계가 다릅니다. 프롬프트가 아예 접수되지 않은 입력 단계 차단("The prompt could not be submitted…"), 프롬프트는 통과했지만 생성 결과가 걸린 출력 단계 차단("The model output could not be generated…"), 그리고 코딩·보안·생물학 질문에서 오탐이 있을 수 있다고 스스로 밝히는 문구("This request was blocked by Gemini's filters…")입니다. Gemini 앱, Google AI Studio, 그리고 Gemini API 위에 만들어진 캐릭터 챗·삽화 모듈·창작 도구·코딩 에이전트 어디서든 만날 수 있고, API에서는 같은 일이 promptFeedback.blockReason: "PROHIBITED_CONTENT" 또는 candidates[].finishReason: "PROHIBITED_CONTENT"로 기록됩니다.
판단의 핵심은 두 가지입니다. 첫째, 문구에 "sensitive words"라고 쓰여 있지만 특정 단어와 일치해서 막힌 것이 아니라, 분류기가 요청 전체의 의미를 Google의 "생성형 AI 금지된 사용 정책"(2024년 12월 17일 최종 수정) 위반으로 판정한 것입니다. 단어 몇 개를 바꿔도 의미가 같으면 같은 판정이 나옵니다. 둘째, PROHIBITED_CONTENT·BLOCKLIST와 아동 안전 같은 내장 보호는 안전 설정으로 조정할 수 없습니다. 안전 설정의 4개 카테고리 기준점으로 달라지는 차단은 SAFETY 코드 하나뿐입니다(2026년 9월 30일 기준, Gemini API 안전 설정 문서). 아래는 이 구분을 화면별·코드별로 확인하고, 원인 구간을 격리해 다시 쓰거나 중단을 결정하는 순서입니다.
"The prompt could not be submitted." — 입력 단계에서 거절된 요청
The prompt could not be submitted. The prompt contains sensitive words that violate Google's Generative AI Prohibited Use Policy. Try rephrasing the prompt. If you think this was an error, send feedback.
이 문구는 프롬프트가 모델에 전달되기 전에 입력 분류기가 거절했다는 뜻이며, 모델은 아무것도 생성하지 않았습니다. Gemini API에서는 응답에 후보(candidates)가 하나도 없고, 대신 promptFeedback.blockReason에 PROHIBITED_CONTENT, promptFeedback.blockReasonMessage에 위 문장이 그대로 들어옵니다. 2026년 6월 16일 아카라이브에 올라온 캐릭터 챗 삽화 모듈의 오류 화면이 정확히 이 JSON이었습니다. google-genai SDK를 쓰면 예외로 올라와서 HTTP 400 invalid_request에 "Input blocked: The prompt could not be submitted. …" 메시지가 붙습니다(2026년 7월 7일 Google AI Developers Forum 보고, 2026년 9월 30일 기준).
여기서 두 가지 오해를 정리해야 합니다.
- 계정이나 모델 접근 권한 문제가 아닙니다. 2026년 7월 7일 포럼 보고자는 결제를 켠 키로 미리보기 모델을 호출하다 이 400 오류를 받고 접근 권한이 없는 줄 알았지만, 7월 8일 답변은 "안전 필터가 그 프롬프트 내용을 막은 것이지 모델 자격이 없다는 뜻이 아니다"였고, 긴 입력 어딘가에 걸릴 만한 내용이 묻혀 있는지 확인하라는 것이었습니다. 다른 프롬프트를 같은 키로 보내서 정상 응답이 오면 키와 계정은 문제가 없습니다.
- 안전 설정으로 풀리지 않습니다.
PROHIBITED_CONTENT는 4개 카테고리 기준점과 별개로 작동하는 정책 분류기입니다.BLOCK_NONE이나OFF로 바꿔도 이 코드는 그대로 나옵니다. 2026년 9월 14일 포럼의 보안 테스트 오탐 사례에서 한 사용자가 "안전 설정을 끄거나 단어를 바꿔 보라"고 답했지만, 이 층의 차단에는 해당하지 않는 조언입니다.
Gemini 앱과 Google AI Studio에서는 코드 대신 이 영어 문구가 보입니다. 제3자 캐릭터 챗·롤플레이 앱에서는 앱이 오류를 어떻게 표시하는지에 따라 문구가 그대로 보이거나 JSON이 노출되거나 "응답 생성 실패" 정도로만 보입니다. 어느 경우든 뜻은 같습니다: 방금 보낸 요청(시스템 프롬프트, 캐릭터 설정, 대화 기록, 첨부 이미지를 모두 합친 것)이 입력 단계에서 정책 위반으로 판정됐습니다.
"The model output could not be generated." — 출력 단계에서 걸린 결과
The model output could not be generated. This output contains sensitive words that violate Google's Generative AI Prohibited Use Policy. If you think this was an error, send feedback.
이 문구는 프롬프트는 통과했지만 모델이 만들어 낸 결과가 정책 위반으로 판정되어 전달되지 않았다는 뜻입니다. Gemini API에서는 후보가 반환되되 finishReason이 PROHIBITED_CONTENT이고, finishMessage에 이 문장이 들어옵니다. SDK JSDoc은 이 코드를 "Token generation stopped for potentially containing prohibited content."라고 설명합니다(2026년 9월 30일 기준). 스트리밍 호출에서는 필터가 출력을 막으면 본문이 비어 있을 수 있어서, 앱 입장에서는 "답이 안 온다"로만 보이기도 합니다.
입력 차단과 다른 점은 원인이 요청 문장 자체가 아니라 모델이 그 요청을 어디로 끌고 갔는지에 있다는 것입니다. 롤플레이 챗에서 대화가 몇 턴에 걸쳐 친밀하거나 폭력적인 방향으로 흘러가면, 마지막 사용자 입력은 무난해도 모델이 이어 쓴 장면이 걸립니다. 이미지 생성이라면 프롬프트에 없는 요소를 모델이 그려 넣어 IMAGE_PROHIBITED_CONTENT나 IMAGE_SAFETY가 나오는 경우가 여기에 해당합니다.
조치도 그래서 다릅니다. 원하는 최종 장면이나 문장을 프롬프트에 직접 지정해 모델이 방향을 정하지 않게 하고, 등장인물이 성인임을 명시하고, 카메라·복장·행동을 구체적으로 적습니다. 이것은 필터를 피하는 방법이 아니라 모델의 해석 여지를 줄여 의도한 결과만 나오게 하는 방법이며, 의도한 결과 자체가 정책 금지 범위라면 어떤 문장으로 써도 같은 지점에서 멈춥니다.
"This request was blocked by Gemini's filters." — 오탐 가능성을 스스로 밝히는 문구
This request was blocked by Gemini's filters. They can occasionally trigger by mistake on safe coding, security, or biology-related queries. Please try rephrasing your prompt. You can send feedback or read more about our policies here.
이 문구는 사용자들이 그대로 붙여 보고하는 것으로, 어느 화면에서 나오는지는 공개 문서에 기재가 없습니다. 문장 내용상 코딩·보안·생물학 질문을 다루는 개발 도구 쪽에서 보이는 것으로 읽히지만 특정 제품의 메시지라고 단정할 근거는 없습니다. 중요한 것은 Google 자신이 이 문구에서 "안전한 코딩, 보안, 생물학 관련 질문에서 실수로 발동할 수 있다"고 인정한다는 점입니다. 즉 이 층의 오탐은 실제로 있고, 피드백 링크가 그 보고 경로입니다.
날짜가 붙은 예가 하나 있습니다. 2026년 9월 14일 Google AI Developers Forum 보고에서 코딩 에이전트가 작성한 테스트 요약("adversarial mutation testing", <script> 주입 테스트 케이스, "mutant killers"라는 표현 포함)이 "The prompt could not be submitted…" 문구로 거절됐습니다. 방어 목적의 보안 테스트 용어가 공격 지시로 분류된 사례이고, 2026년 9월 30일 기준 Google 측 공식 답변은 없습니다. 이런 요청에서 할 수 있는 것은 공격 페이로드 문자열과 설명을 분리해 보내기, 테스트 코드는 코드 블록 안에 두고 자연어로 "무엇을 검증하는 테스트인지"를 앞에 적기, 그리고 피드백 링크로 오탐을 보고하기입니다. 코드가 실제로 악성 동작을 만드는 것이라면 정책상 "불법 활동"과 "악성 소프트웨어" 범위에 들어가므로 여기서 멈춰야 합니다.
차단 코드별 의미와 조정 가능 여부
Gemini API가 반환하는 코드는 세 곳에 나뉘어 있습니다. 입력 차단은 promptFeedback.blockReason, 출력 차단은 candidates[].finishReason, 오류 코드 문서에는 소문자 형태(prohibited_content 등)로 같은 개념이 정리되어 있습니다. 아래 표는 2026년 9월 30일 기준 Gemini API 문서와 google-genai SDK 타입 정의의 설명을 그대로 옮기고, 안전 설정으로 결과가 달라지는지를 붙인 것입니다. Vertex AI 전용 코드(MODEL_ARMOR, JAILBREAK)는 Gemini API에서는 나오지 않습니다.
| 코드 | 나타나는 위치 | Google 문서 원문 | 뜻 | 안전 설정으로 달라지나 |
|---|---|---|---|---|
SAFETY | blockReason / finishReason | "The prompt was blocked for safety reasons." / "Token generation stopped because the content potentially contains safety violations." | 4개 카테고리 중 하나가 설정한 기준점을 넘음. safetyRatings에 카테고리와 확률이 함께 옴 | 예. 기준점을 낮추면 통과할 수 있음 |
PROHIBITED_CONTENT | blockReason / finishReason | "The prompt was blocked because it contains prohibited content." / "Token generation stopped for potentially containing prohibited content." | 금지된 사용 정책 위반으로 판정. "The prompt could not be submitted…" 문구가 여기에 붙음 | 아니요 |
BLOCKLIST | blockReason / finishReason | "…contains a term from the terminology blocklist." / "…contains forbidden terms." | Google이 관리하는 용어 차단 목록(blocklist)에 해당하는 용어 포함 | 아니요 |
OTHER | blockReason | "…may be due to the prompt's language, or because it contains other harmful content." | 언어 미지원, 서비스 약관 위반, 기타 지원되지 않는 요청 | 아니요 |
SPII | finishReason | "Sensitive Personally Identifiable Information restrictions blocked the request."(오류 코드 문서 spii) | 출력에 민감한 개인 식별 정보가 포함될 가능성 | 아니요 |
RECITATION | finishReason | 오류 코드 문서에 recitation으로 등재, 설명 문구 없음 | 출력이 특정 자료를 그대로 재현할 가능성. 문제 해결 문서는 프롬프트와 컨텍스트를 더 고유하게 만들고 temperature를 올리라고 안내 | 아니요(안전 설정과 무관) |
IMAGE_SAFETY | blockReason / finishReason | "…content that is unsafe for image generation." / "…generated images have safety violations." | 이미지 생성 요청 또는 생성된 이미지가 안전 위반 | 문서에 조정 가능 여부 명시 없음 |
IMAGE_PROHIBITED_CONTENT | finishReason | "Image generation stopped because the generated images have prohibited content." | 생성된 이미지가 금지 콘텐츠로 판정 | 아니요 |
NO_IMAGE | finishReason | "The model was expected to generate an image, but none was generated." | 차단이 아니라 이미지가 만들어지지 않은 것. 프롬프트가 이미지 요청으로 해석되지 않았을 가능성 | 해당 없음 |
오류 코드 문서의 소문자 코드는 같은 뜻입니다. prohibited_content는 "Prohibited content guidelines blocked the request.", blocklist는 "Prohibited terms on a blocklist blocked the request.", safety는 "Safety violations (harmful content) blocked the request.", image_prohibited_content는 "Prohibited content guidelines blocked image generation."입니다. 로그나 오류 메시지에서 소문자 prohibited_content만 봤다면 대문자 PROHIBITED_CONTENT와 같은 층, 즉 조정 불가능한 정책 차단입니다.
안전 설정으로 해결되는지 판정하는 규칙
안전 설정은 Gemini API의 4개 카테고리에 대해 차단 기준점을 정하는 기능입니다. Google 한국어 문서의 표기로는 괴롭힘(HARM_CATEGORY_HARASSMENT), 증오심 표현(HARM_CATEGORY_HATE_SPEECH), 음란물(HARM_CATEGORY_SEXUALLY_EXPLICIT), 위험(HARM_CATEGORY_DANGEROUS_CONTENT)이고, 기준점은 OFF(꺼짐), BLOCK_NONE(차단 안함), BLOCK_ONLY_HIGH(소수 차단), BLOCK_MEDIUM_AND_ABOVE(일부 차단), BLOCK_LOW_AND_ABOVE(대부분 차단)입니다. 각 응답의 safetyRatings에는 카테고리별 확률이 NEGLIGIBLE/LOW/MEDIUM/HIGH로 옵니다(2026년 9월 30일 기준).
여기서 판정 규칙이 나옵니다.
blockReason또는finishReason이SAFETY이고safetyRatings에MEDIUM이상인 카테고리가 있으면, 그 카테고리의 기준점이 원인입니다. 기준점을 낮추면 통과할 수 있습니다. 단, 낮춰서 나오는 결과가 정책 금지 범위라면 다음 층(PROHIBITED_CONTENT)에서 다시 막힙니다.- 기준점을 설정하지 않았는데 차단됐다면, Gemini 2.5·3 계열 모델에서는 기본 기준점이
OFF이므로 4개 카테고리가 원인일 수 없습니다. Google 문서 원문은 "If the threshold is not set, the default block threshold is Off for Gemini 2.5 and 3 models."입니다(2026년 9월 30일 기준). 이 경우 차단은 거의 확실히 조정 불가능한 층(정책 분류기, 용어 차단 목록, 내장 보호)에서 났고, 코드도SAFETY가 아닐 것입니다. - 코드가
PROHIBITED_CONTENT,BLOCKLIST,IMAGE_PROHIBITED_CONTENT이면 안전 설정은 결과를 바꾸지 않습니다. 남는 선택은 요청을 다시 쓰기, 오탐 피드백, 중단 세 가지입니다. - 아동 안전 등 내장 보호는 항상 차단됩니다. 문서 원문은 "The Gemini API has built-in protections against core harms, such as content that endangers child safety. These types of harm are always blocked and cannot be adjusted."이며, 어떤 카테고리가 내장 보호에 포함되는지는 전부 열거되어 있지 않습니다.
제3자 앱 사용자에게 이 규칙이 뜻하는 것은 하나입니다. 앱 개발자가 기준점을 BLOCK_LOW_AND_ABOVE처럼 엄격하게 설정했다면 SAFETY 차단이 자주 나고 이는 개발자만 바꿀 수 있습니다. 반면 "The prompt could not be submitted…" 문구가 보였다면 그 앱이 안전 설정을 어떻게 했든 결과는 같았을 것이고, 요청 내용(캐릭터 설정·대화 기록·이미지 포함) 쪽을 봐야 합니다.
코드에서 안전 설정을 명시하고 차단 이유를 읽는 방법
자기 코드로 Gemini API를 호출한다면 두 가지를 반드시 해 두어야 합니다. 안전 설정을 명시적으로 넣어 기본값에 의존하지 않기, 그리고 차단이 났을 때 blockReason·finishReason·safetyRatings를 최종 프롬프트 텍스트와 함께 로그로 남기기입니다. 이 로그가 없으면 "가끔 응답이 비어 있다"는 보고를 진단할 수 없습니다. Python google-genai 기준 예시입니다(2026년 9월 30일 기준 SDK 필드명).
hljs pythonfrom google import genai
from google.genai import types, errors
client = genai.Client() # GEMINI_API_KEY 환경 변수를 읽습니다
safety = [
types.SafetySetting(category="HARM_CATEGORY_HARASSMENT", threshold="BLOCK_ONLY_HIGH"),
types.SafetySetting(category="HARM_CATEGORY_HATE_SPEECH", threshold="BLOCK_ONLY_HIGH"),
types.SafetySetting(category="HARM_CATEGORY_SEXUALLY_EXPLICIT", threshold="BLOCK_MEDIUM_AND_ABOVE"),
types.SafetySetting(category="HARM_CATEGORY_DANGEROUS_CONTENT", threshold="BLOCK_MEDIUM_AND_ABOVE"),
]
def generate(prompt: str) -> str | None:
try:
response = client.models.generate_content(
model="gemini-2.5-flash",
contents=prompt,
config=types.GenerateContentConfig(safety_settings=safety),
)
except errors.APIError as e:
# SDK가 입력 차단을 HTTP 400 예외로 올리는 경우:
# "Input blocked: The prompt could not be submitted. ..."
print("API 오류", e.code, e.message)
return None
fb = response.prompt_feedback
if fb is not None and fb.block_reason:
# 입력 단계 차단: 후보 없음
print("입력 차단", fb.block_reason, fb.block_reason_message)
return None
if not response.candidates:
print("후보 없음")
return None
cand = response.candidates[0]
if cand.finish_reason and cand.finish_reason.name != "STOP":
# 출력 단계 차단 또는 기타 중단 사유
print("finishReason", cand.finish_reason.name)
for rating in cand.safety_ratings or []:
print(" ", rating.category, rating.probability)
return None
return response.text
읽는 법은 표와 같습니다. fb.block_reason이 SAFETY이고 뒤에 safety_ratings에 MEDIUM 이상 카테고리가 찍히면 위 safety 목록의 해당 기준점을 조정할 수 있습니다. PROHIBITED_CONTENT나 BLOCKLIST가 찍히면 이 코드의 어떤 설정도 결과를 바꾸지 못하므로, 로그에 남은 최종 프롬프트 텍스트를 가지고 다음 절의 격리 절차로 넘어갑니다. 이미지 모델(gemini-3.1-flash-image, gemini-3-pro-image 등)도 같은 필드로 읽되 finish_reason에 IMAGE_SAFETY, IMAGE_PROHIBITED_CONTENT, NO_IMAGE가 추가로 나올 수 있습니다.
원인 구간을 격리하는 절차
차단 코드가 조정 불가능한 층이라고 확인됐거나, 코드를 볼 수 없는 앱 사용자라면, 요청의 어느 부분이 판정을 만들었는지 격리해야 합니다. 매 요청에 실제로 전송되는 것은 지금 입력한 한 줄이 아니라 시스템 프롬프트, 캐릭터 카드, 세계관 설정, 대화 기록 전체, 첨부 이미지를 합친 덩어리라는 점을 전제로 진행합니다.
- 최소 프롬프트부터 시작합니다. 의도한 최종 장면이나 문장을 한두 문장으로만 써서 보냅니다. 설정·기록·이미지는 모두 뺍니다. 이것이 막히면 요청의 목표 자체가 정책 범위에 들어가는지 먼저 판단해야 하고, 통과하면 원인은 뺀 부분에 있습니다.
- 뺀 부분을 단락 단위로 하나씩 되돌립니다. 시스템 프롬프트 → 캐릭터 설정 → 대화 기록(최근 것부터) 순서로 넣고, 어느 단락을 넣은 순간 막히는지 기록합니다. 캐릭터 챗에서는 캐릭터 카드나 롤플레이 지침 안의 한 단락이 원인인 경우가 많고, 이 경우 지금 입력한 문장을 아무리 바꿔도 결과가 같습니다.
- 이미지 편집이라면 네 가지 조합을 테스트합니다. 원본 이미지 × 원본 프롬프트, 원본 이미지 × 짧은 프롬프트("배경만 밝게"), 무난한 이미지(풍경·사물) × 원본 프롬프트, 무난한 이미지 × 짧은 프롬프트. 결과 해석은 아래 표와 같습니다.
- 찾은 단락을 의도한 결과 기준으로 다시 씁니다. 어떤 장면이 나와야 하는지를 직접 쓰고, 등장인물이 성인임을 명시하고, 나이를 애매하게 만드는 표현("소녀", "학생", "어린" 등)을 성적·폭력적·친밀한 맥락 근처에 두지 않습니다. 붙여 넣은 외부 자료, 개인 정보(전화번호·주소·주민등록번호 류), 불법 행위의 구체적 지시가 섞여 있으면 그 부분을 제거합니다. 이것은 문장을 명확하게 만드는 일이지 단어를 치환해 분류기를 속이는 일이 아닙니다. 후자는 정책의 "악용 방지 또는 보안 필터 회피" 조항에 그 자체로 해당합니다.
- 다시 써도 오탐이라고 판단되면 문구의 피드백 링크로 보고합니다. 방어적 보안 용어, 의학·생물학 설명, 뉴스·역사 서술이 여기에 해당하는 경우가 있습니다. 정책은 "교육, 학술, 과학, 예술적 고려사항이 있거나 공익이 해악보다 크다고 판단될 경우" 예외를 둘 수 있다고 적고 있지만, 예외 적용은 분류기가 아니라 검토 절차의 일이므로 요청을 다시 보내는 것으로 해결되지는 않습니다.
- 중단합니다. 격리 결과 원인이 성적 콘텐츠, 미성년자, 실존 인물의 친밀·폭력 장면, 동의 없는 사적 이미지, 자해·불법 행위 조장 중 하나라면 정책이 금지하는 범위이고, 다른 표현으로 시도하는 것 자체가 금지 조항에 해당합니다.
이미지 편집 4가지 테스트의 해석은 다음과 같습니다.
| 통과한 조합 | 차단된 조합 | 판정 | 다음 행동 |
|---|---|---|---|
| 무난한 이미지가 들어간 두 조합 통과 | 원본 이미지가 들어간 두 조합 모두 차단 | 업로드한 이미지 자체가 원인 | 이미지에 무엇이 있는지 확인(아래 분류 참고). 그 요소가 정책 범위면 중단 |
| 원본 이미지 × 짧은 프롬프트도 통과 | 원본 프롬프트가 들어간 두 조합만 차단 | 프롬프트 문장이 원인 | 4번 절차대로 다시 쓰기 |
| 원본 이미지 × 짧은 프롬프트, 무난한 이미지 × 원본 프롬프트 모두 통과 | 원본 이미지 × 원본 프롬프트만 차단 | 이미지와 지시가 결합된 의미가 원인(예: 실존 인물 사진 + 복장·신체를 바꾸는 지시) | 결합된 의미가 정책 범위면 중단. 아니라면 의도한 결과를 더 구체적으로 지정 |
| 하나도 통과하지 않음 | 네 조합 모두 차단 | 요청 내용이 아닌 다른 문제(도구의 설정, 모델 미지원, 다른 오류 코드) | blockReason이 아닌 HTTP 상태와 오류 코드를 확인 |
이미지 필터가 무엇을 보는지는 Vertex AI Imagen의 책임감 있는 AI 문서(2026년 9월 30일 기준)가 분류를 공개하고 있습니다. 아동, 유명인, 사람/얼굴, 성적, 폭력, 개인 정보, 혐오, 위험, 저속한 표현, 제3자 콘텐츠, 금지 콘텐츠입니다. 이 분류와 지원 코드는 Vertex AI Imagen의 것이고 Gemini API는 위 표의 FinishReason 값을 반환하므로, "이미지 필터가 어떤 종류의 요소에 반응하는가"를 파악하는 용도로만 참고합니다. 사람 얼굴이 크게 나온 사진, 특히 아동으로 보일 수 있는 인물이나 알려진 인물의 사진은 지시가 무난해도 이 층에서 걸릴 수 있습니다. 2026년 3월 13일 포럼 보고에서 Veo 3.1 이미지→동영상이 광고용 스토리보드를 아동 안전 오탐으로 막았고 미성년자 언급을 지운 뒤에도 차단이 유지된 사례가 있습니다. 제품은 다르지만 같은 정책 계열의 아동 안전 필터가 과하게 반응할 수 있음을 보여 줍니다.
화면별로 할 수 있는 일
같은 차단이라도 보고 있는 화면에 따라 손에 있는 정보와 가능한 조치가 다릅니다.
| 화면 | 보이는 정보 | 할 수 있는 것 | 할 수 없는 것 |
|---|---|---|---|
| Gemini 앱 | 영어 문구만 | 프롬프트 다시 쓰기, 첨부 이미지 교체, 새 대화에서 최소 프롬프트로 테스트, 피드백 보내기 | 안전 설정 조정(앱에는 노출되지 않음), 코드 확인 |
| Google AI Studio | 문구 + 안전 설정 패널 | 4개 카테고리 기준점 조정(SAFETY에만 효과), 시스템 지침·대화 기록 단락별 제거, 같은 프롬프트를 다른 모델로 시도 | PROHIBITED_CONTENT·BLOCKLIST·내장 보호 해제 |
| 제3자 앱(캐릭터 챗·삽화 모듈·창작 도구) | 앱이 보여 주는 만큼(문구, JSON, 또는 "실패"만) | 캐릭터 카드·지침·대화 기록 줄이기, 새 세션에서 최소 입력 테스트, 앱 개발자에게 안전 설정과 오류 표시 방식 문의 | 앱의 안전 설정 변경, blockReason 직접 확인 |
| 자기 코드 | blockReason, finishReason, safetyRatings, HTTP 상태 | 안전 설정 명시, 로그, 격리 자동화(단락별 재시도), 사용자에게 원인 구간 안내 | 정책 층 우회 |
제3자 앱 사용자가 가장 답답한 지점은 코드를 볼 수 없다는 것입니다. 이때 쓸 수 있는 구분법은 문구입니다. "The prompt could not be submitted…"가 보였다면 입력 단계 PROHIBITED_CONTENT이고 앱 설정과 무관합니다. 문구 없이 응답만 비어 있거나 잘린다면 출력 단계이거나 앱이 오류를 삼킨 것이어서, 개발자에게 finishReason을 표시해 달라고 요청하는 것이 다음 단계입니다.
오탐으로 확인됐는데 같은 프롬프트가 계속 실패할 때
격리 절차를 끝냈고, 요청이 정책 범위 밖이라고 확신하며, 피드백도 보냈지만 같은 프롬프트가 Gemini에서 계속 막히는 경우가 있습니다. 텍스트라면 다른 Gemini 모델이나 Google AI Studio에서 같은 프롬프트를 시도해 모델 차이를 확인하는 정도가 남습니다. 이미지라면 다른 회사의 이미지 모델에서 같은 정당한 프롬프트를 시도해 볼 수 있습니다. 분류기는 모델·제공자마다 다르므로, 한쪽의 오탐이 다른 쪽에서 재현되지 않는 경우가 있습니다.
YingTu 브라우저 스튜디오에서는 자신의 LaoZhang API 키를 붙여 넣어 GPT Image 2, Seedream, Nano Banana 계열을 같은 화면에서 시도할 수 있고, 이미지당 결제입니다(2026년 9월 26일 기준 Nano Banana Pro $0.09, GPT Image 2 VIP $0.03, Seedream 5.0 Flash $0.018, 구독 없음). 두 가지 전제가 있습니다. 첫째, 여기의 Nano Banana Pro는 Google의 gemini-3-pro-image를 그대로 쓰는 것이므로 Google 쪽에서 막힌 프롬프트는 여기서도 같은 필터를 만납니다. 다른 결과를 기대할 수 있는 것은 GPT Image 2와 Seedream 같은 다른 제공자의 모델입니다. 둘째, YingTu 스튜디오도 자체 출력 검사를 거치며 정책 위반 콘텐츠는 똑같이 거부하므로, Google에서 막힌 이유가 정책 범위였다면 여기서도 결과는 같습니다. 모델별 가격·출력 크기·프롬프트 예시는 Nano Banana Pro 가격과 사용법에서 확인할 수 있습니다.
자주 묻는 질문
prohibited_content가 정확히 무슨 뜻인가요?
Gemini API가 요청 또는 생성 결과를 Google의 생성형 AI 금지된 사용 정책 위반으로 판정해 차단했다는 코드입니다. 오류 코드 문서의 설명은 "Prohibited content guidelines blocked the request."이고, 응답 필드에서는 대문자 PROHIBITED_CONTENT로 promptFeedback.blockReason(입력 차단) 또는 finishReason(출력 차단)에 나옵니다(2026년 9월 30일 기준). 안전 설정의 기준점과는 별개로 작동하므로 설정을 바꿔도 결과가 달라지지 않습니다.
BLOCK_NONE으로 설정했는데도 왜 막히나요?
BLOCK_NONE과 OFF는 괴롭힘·증오심 표현·음란물·위험 4개 카테고리의 기준점만 바꿉니다. PROHIBITED_CONTENT, BLOCKLIST, 아동 안전 같은 내장 보호는 이 설정 바깥에 있고 Google 문서가 "항상 차단되며 조정할 수 없다"고 명시합니다. Gemini 2.5·3 계열은 기준점을 지정하지 않아도 기본이 OFF이므로, 이 모델에서 차단을 봤다면 설정 문제가 아닐 가능성이 큽니다.
무난한 편집 지시인데 왜 실패하나요?
지시 문장이 아니라 업로드한 이미지가 원인인 경우가 많습니다. 사람 얼굴이 크게 나온 사진, 아동으로 보일 수 있는 인물, 알려진 인물, 노출이 있는 이미지는 지시가 "배경만 바꿔"여도 이미지 필터 층에서 걸릴 수 있습니다. 원본 이미지 × 짧은 프롬프트와 무난한 이미지 × 원본 프롬프트 두 조합을 보내 보면 어느 쪽이 원인인지 갈립니다.
계정이 제한된 건가요?
아닙니다. 이 문구는 특정 요청의 내용에 대한 판정이고 계정·키·결제 상태와 무관합니다. 같은 키로 다른 프롬프트를 보내 정상 응답이 오면 확인됩니다. 2026년 7월 7일 포럼 보고자도 결제를 켠 키로 이 400 오류를 받고 접근 권한 문제로 오해했지만, 답변은 프롬프트 내용이 원인이라는 것이었습니다.
캐릭터 챗 앱 사용자는 무엇을 할 수 있나요?
코드와 안전 설정은 앱 개발자만 다루므로, 사용자가 할 수 있는 것은 요청 내용 쪽입니다. 새 세션에서 캐릭터 카드와 지침 없이 최소 입력으로 테스트해 통과 여부를 확인하고, 통과하면 캐릭터 카드·롤플레이 지침·대화 기록을 단락 단위로 되돌려 원인 단락을 찾습니다. "The prompt could not be submitted…" 문구가 보였다면 앱 설정으로는 해결되지 않는 층이며, 원인 단락이 성적 콘텐츠·미성년자·실존 인물의 친밀 장면 등 정책 범위라면 어떤 앱에서도 같은 결과가 나옵니다.
문구에 "sensitive words"라고 쓰여 있으니 단어만 바꾸면 되나요?
아닙니다. 분류기는 요청 전체의 의미를 판정하므로 같은 뜻의 다른 단어로 바꿔도 결과가 같고, 분류기를 속이기 위한 치환은 정책의 "악용 방지 또는 보안 필터 회피" 조항에 해당합니다. 효과가 있는 것은 의도한 최종 결과를 명확하게 지정하고 애매한 나이·맥락 표현을 없애는 것이며, 의도한 결과가 정책 범위라면 어떤 표현으로도 통과하지 않습니다.