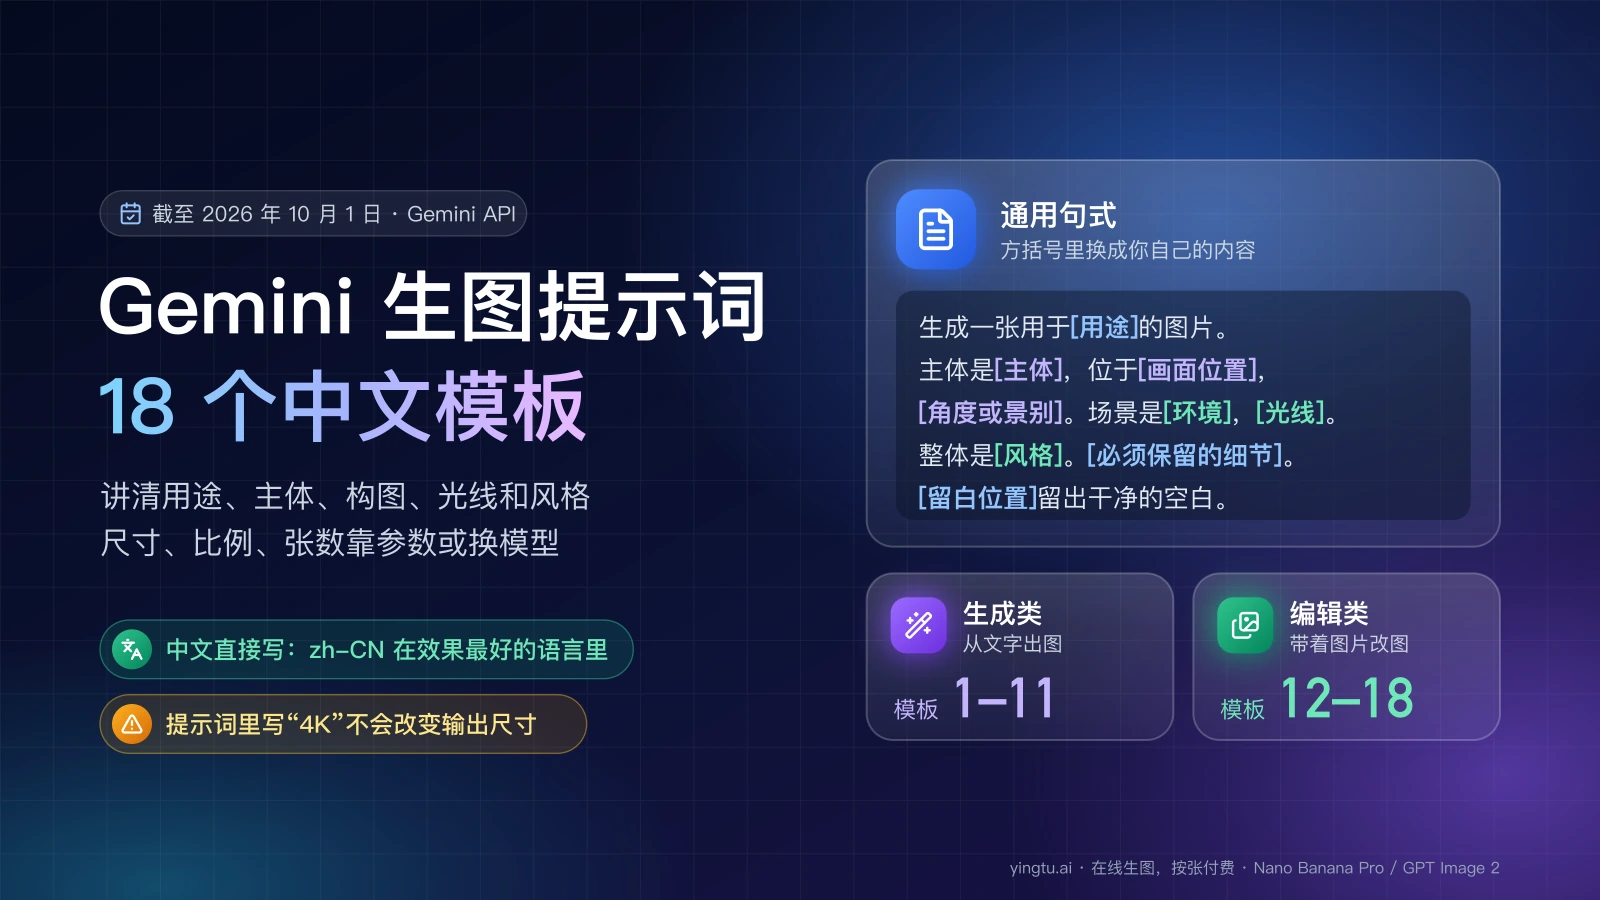
Gemini 生图提示词是你写给 Gemini 图片模型(Google 把这项能力叫 Nano Banana)的一段画面说明。它用完整的句子最好用:说清这张图用在哪、画什么、怎么摆、什么光、什么风格、哪些地方必须保留。中文可以直接写,Google 的文档把 zh-CN 列在效果最好的语言里。
赶时间的话,先拿这条通用句式去改:
hljs text生成一张用于[用途]的图片。 主体是[主体的材质、颜色、状态],位于[画面位置],[拍摄角度或景别]。 场景是[环境],[光线]。整体是[风格]。 [必须保留或必须出现的细节]。[留白位置]留出干净的空白。
开头的“生成一张……的图片”有实际作用。Google Cloud 的文档提醒,Gemini 是多模态模型,不说明要图片时可能只回一段文字。
下面 18 条模板按 Google 提示词指南现行的分类排列:生成 7 类(模板 1–11)、编辑 7 类(模板 12–18)。它们是按 Google 英文模板的结构改写成中文的,方括号里换成你自己的内容即可。有三件事提示词说了不算,要靠参数或换模型:输出尺寸、精确张数、参考图数量,后面有一张对照表。
一条提示词要写清的七样东西
| 要写的内容 | 回答什么问题 | 写法举例 |
|---|---|---|
| 用途 | 这张图放在哪里 | 电商主图、网页首屏、活动海报、公众号封面 |
| 主体 | 画的是什么,长什么样 | 一只磨砂黑陶瓷马克杯、一只戴草帽的柴犬 |
| 构图 | 主体放在哪,从哪个角度看 | 居中、右侧三分之一处、45 度俯拍、微距 |
| 场景与光线 | 周围是什么,光从哪来 | 浅灰水泥台面,左上方柔光;傍晚窗边逆光 |
| 风格 | 看起来像哪一类图 | 写实摄影、扁平插画、水墨、3D 图标 |
| 必须保留的细节 | 哪些东西要出现或不能变 | 瓶身标签位置、角色的红围巾、Logo 的形状 |
| 比例与留白 | 横竖和文字空间 | 16:9 横图,左侧三分之一留白放标题 |
七样不必每次写满。Google 给出的做法里第一条就是“写得足够具体”:与其写“奇幻盔甲”,不如写出材质、纹样和轮廓。第二条是说明用途:“为一个高端极简护肤品牌设计 Logo”比“设计一个 Logo”更容易得到合适的结果。所以用途和主体两样不能省,其余按这张图的需要添。
填好的例子:
hljs text生成一张用于护肤品牌网页首屏的图片。 主体是一瓶透明玻璃精华液,瓶身标签朝向镜头,位于画面右侧三分之一处,平视拍摄。 场景是干净的白色浴室台面,上午的自然光从左侧窗户照进来,台面上有淡淡的倒影。 整体是安静克制的写实产品摄影。 画面里只有这一瓶产品。左侧三分之二留出干净的空白。
生成类模板:从文字出图
1. 写实照片
把自己当成在给摄影师交代拍什么。要填:景别、主体、地点、光线、机位、镜头。
hljs text生成一张写实照片:[景别,如特写/中景/广角]拍摄的[主体及细节],地点是[场景]。 [光线的来源、方向和质感]。 从[机位,如平视/低角度/俯拍]拍摄,使用[镜头,如广角/85mm 人像/微距]。
例子:
hljs text生成一张写实照片:近景拍摄的一位老陶艺师傅,戴着沾了泥点的围裙,正低头检查一只刚上釉的茶碗,地点是他堆满陶坯的工作室。 傍晚的暖光从侧面窗户照进来,照出泥土的颗粒和手上的皱纹。 平视拍摄,使用 85mm 人像镜头,背景柔和虚化。
2. 插画与贴纸
要填:风格、主体和它的配饰或动作、线条和上色方式、背景颜色。
hljs text生成一张[风格]的[贴纸/插画]:[主体,带配饰或表情]正在[动作]。 线条[粗细和特点],上色[平涂/赛璐璐/水彩],配色[色调]。 背景是[纯白/指定颜色]。
例子:
hljs text生成一张可爱风格的贴纸:一只开心的小熊猫,戴着一顶小竹帽,正在啃一片绿竹叶。 线条粗而干净,上色用简单的赛璐璐阴影,配色鲜艳。 背景是纯白色。
3. App 图标
图标属于插画的一种,但要求更窄:小尺寸下要认得出来。
hljs text生成一个[产品或功能]的 App 图标。 用[主图形]表达[核心概念],配色是[主色]加[辅助色]。 图形简洁,线条粗,缩小到很小时依然清晰;整个图标只有图形。 背景是[颜色],图形四周留出均匀的边距。
4. 带文字的 Logo 或标题图
要填:图的类型、品牌或主题、加引号的原文、字体的样子、整体风格、配色。字体用描述而不是字体名,比如“粗的无衬线体”“手写毛笔字”。
hljs text为[品牌或主题]生成一张[Logo/封面/招牌],上面的文字是“[要出现的原文]”, 字体是[字体描述]。 整体设计[风格描述],配色[颜色方案]。
例子:
hljs text为一家名叫“每日研磨”的咖啡店生成一个现代极简的 Logo,上面的文字是“每日研磨”, 字体是干净的粗黑体。 配色只用黑白两色,Logo 放在一个圆形里,把一颗咖啡豆巧妙地融进图形。
Google 建议专业级的带字素材用 Nano Banana Pro。
5. 活动海报
海报上的字多,按 Google 的说法,先把文字定下来再让它进图,效果最好。分两步:
hljs text第一步: 为[活动]写一套海报文案:主标题不超过 8 个字,副标题一行,时间和地点各一行。只输出文案。 第二步: 用上面的文案生成一张[比例]的海报。 主视觉是[核心画面],风格是[电影感/极简/复古/科技感]。 主标题在顶部,字体是[字体描述];时间和地点在底部,字号较小、排成两行。 文字与上面的文案逐字一致。
如果成图里的小字仍然不准,就让模型只留空白:把第二步最后两句换成“顶部和底部各留出干净的空白区域”,文字用设计软件加上去。
6. 信息图
同样先定文字。要填:主题、步骤数、每步的图标风格。
hljs text第一步: 把[概念或流程]拆成[数量]个步骤,每一步写一个不超过 6 个字的标题和一句不超过 15 个字的说明。只输出文字。 第二步: 用上面的文字生成一张[比例]的信息图。 [数量]个步骤从[左到右/上到下]排列,每一步配一个[风格]的简单图标,步骤之间用箭头连接。 背景是[颜色],标题字大而清晰,说明文字与上面逐字一致。
7. 产品图与电商主图
要填:产品、台面或背景、布光和它的目的、机位和要展示的特征、对焦位置、比例。
hljs text生成一张高分辨率的棚拍产品照片:[产品的材质、颜色、形状],放在[台面或背景]上。 布光是[布光方式,如三点柔光箱],用来[布光目的,如减少反光、突出材质]。 机位是[角度],重点展示[产品特征]。 写实,焦点落在[关键细节]上。[比例]。
例子:
hljs text生成一张高分辨率的棚拍产品照片:一只极简风格的磨砂黑陶瓷马克杯,放在抛光的水泥台面上。 布光是三点柔光箱,光线柔和均匀,高光干净。 机位是略高的 45 度角,重点展示杯子利落的线条。 写实,焦点落在杯中咖啡升起的热气上。方图。
8. 网页首屏背景
大面积留白的图适合后期叠文字。要填:唯一的主体、它的位置、背景颜色、比例。
hljs text生成一张极简构图的图片:只有一个[主体],位于画面的[右下/左上/右侧三分之一]。 背景是大面积的纯[颜色],留出明显的空白用来放文字。 光线柔和、不抢眼。[比例]。
例子:
hljs text生成一张极简构图的图片:只有一片精致的红枫叶,位于画面的右下角。 背景是大面积的米白色,留出明显的空白用来放文字。 柔和的漫射光从左上方照下来。方图。
9. 社交平台竖图
hljs text生成一张用于[平台]的 4:5 竖图。 主体是[产品/宠物/场景],位于画面中央偏上,占画面约一半。 背景是[简洁的环境],颜色比主体浅。 底部四分之一留出干净的空白放一行标题。配色明亮,在手机上一眼能看清主体。
10. 分镜与多格漫画
要填:格数、画风、角色、每格发生的事。Google 说明这类提示词在 Nano Banana Pro 和 Nano Banana 2 上效果最好。
hljs text生成一张[格数]格漫画,画风是[风格,如高对比黑白墨线/柔和水彩]。 主角是[角色的外形特征],每一格里保持同一个样子。 第一格:[发生的事]。第二格:[发生的事]。第三格:[发生的事]。 对话气泡里的文字是:“[台词一]”“[台词二]”。
例子:
hljs text生成一张 3 格漫画,画风是线条圆润的日常水彩。 主角是一只戴红围巾的橘猫,每一格里保持同一个样子。 第一格:橘猫盯着桌上的一杯水。第二格:它慢慢伸出爪子。第三格:杯子倒了,它一脸无辜地看向镜头。 对话气泡里的文字是:“不是我。”
11. 需要最新信息的图
天气、比赛结果、近期事件这类内容,模型自己并不知道,要打开“使用 Google 搜索建立依据”这个工具,它才会先查再画。提示词本身只需要说清要查什么、画成什么样。
hljs text把[需要最新信息的主题,如某地未来五天的天气/昨晚某场比赛的结果]做成一张[图表类型]。 风格[简洁现代/杂志感],[比例]。 另外加一栏[你想要的补充信息]。
例子:
hljs text把杭州未来五天的天气预报做成一张简洁现代的天气图表,16:9。 另外加一栏每天适合穿什么。
在 API 里要在请求中加上 tools=[{"type": "google_search"}]。Google 的文档注明,Nano Banana 2 的搜索功能目前不会使用网上搜到的真实人物照片。
编辑类模板:带着图片改图
编辑时把图片和提示词一起发给模型。只上传你有权使用的图片,生成内容受 Google 的 Prohibited Use Policy 约束。
12. 添加或移除元素
模型会自动匹配原图的风格、光线和透视,你要说清的是加什么、加在哪、怎么融进去。
hljs text使用这张[主体]的图片,[添加/移除/修改][元素],位置在[具体位置]。 让这处改动[融入方式,如与原图的光线方向一致、带自然的阴影]。
例子:
hljs text使用这张我家猫的照片,在它头上加一顶小小的针织巫师帽。 帽子要像稳稳戴在头上一样,并且和照片里柔和的光线一致。
13. 局部重绘
不用画蒙版,用一句话圈定要改的部分,并明确其余部分原样保留。
hljs text使用这张图片,只把[具体元素]改成[新元素及描述]。 图片的其余部分完全保持原样,包括原来的风格、光线和构图。
例子:
hljs text使用这张客厅的图片,只把蓝色沙发改成一张复古的棕色皮质沙发。 房间的其余部分完全保持原样,包括沙发上的靠垫和光线。
14. 风格迁移
要填:原图主体、目标风格、这种风格的具体特征。
hljs text把这张[主体]的照片转换成[画派或艺术风格]。 保留原来的构图,用[笔触、材质、配色等风格特征]重新绘制所有元素。
例子:
hljs text把这张夜晚城市街道的照片转换成中国水墨画风格。 保留原来楼房和车辆的构图,用浓淡不同的墨色和留白重新绘制所有元素,只在路灯处点一点暖黄。
15. 多图合成
要填:每张图里取什么、放到哪、最终是一张什么样的图。用“第一张图”“第二张图”指代。
hljs text用提供的几张图片合成一张新图。 取第一张图里的[元素],放到第二张图的[元素或位置]上。 最终是一张[成图描述],光线和阴影按[第二张图的环境]调整一致。
例子:
hljs text用提供的两张图片合成一张专业的家居电商照片。 取第一张图里的黄铜台灯,放到第二张图的原木书桌左侧。 最终是一张写实的书房一角照片,台灯的阴影和色温按第二张图的窗边光线调整一致。
16. 保留关键细节
改图时最怕 Logo 或面部跟着变。Google 的做法是把要保留的部分详细描述出来,和修改要求写在一起。
hljs text使用提供的图片,把[第二张图的元素]放到[第一张图的元素]上。 [第一张图里要保留的部分,逐项写出特征]保持完全不变。 新加的元素要[融入方式]。
例子:
hljs text使用提供的两张图片,把第二张图里的圆形茶叶 Logo 印到第一张图的米色帆布包正面。 帆布包的形状、提手的长度、布料的纹理和左下角的皮标保持完全不变。 Logo 要像直接印在布面上一样,随布料的褶皱自然起伏。
17. 草图变成稿
要填:草图的媒介、主体、成稿的样子、保留什么、新增什么。
hljs text把这张[铅笔/马克笔/白板]草图里的[主体]变成一张[成稿风格]的图。 保留草图里的[轮廓、比例等特征],加上[材质、颜色、灯光等新细节]。
例子:
hljs text把这张铅笔草图里的落地灯变成一张摆在客厅里的成品照片。 保留草图里细长的灯杆和倾斜的灯罩,加上哑光黑的金属材质和暖色灯光。
18. 同一角色的多个角度
想让同一个角色出现在多张图里,一次只要一个角度,并把之前生成的图一起传回去当参考;复杂的姿势再附一张姿势参考图。
hljs text生成一张[这个角色]的棚拍肖像,背景是[颜色],[正面/右侧面/四分之三侧面]。 角色的[发型、服装、配饰等特征]与提供的图片保持一致。
例子:
hljs text生成一张这只吉祥物的棚拍肖像,背景是纯白色,右侧面。 它的蓝色围巾、圆耳朵和胸前的星形徽章与提供的图片保持一致。
每条模板出图是什么样,可以对着真实样图看:YingTu 的提示词库里每条可复制的提示词都带实际生成的样图和单张价格,多数还用同一条提示词跑了两三个模型。
提示词管不了的事
下面几样写进提示词也不保证生效,各有对应的解决办法。参数名是 Gemini API 的写法,数字截至 2026 年 10 月 1 日,出自 Google 的图片生成文档。
| 你想控制的 | 写进提示词的结果 | 真正管用的办法 |
|---|---|---|
| 输出尺寸(2K、4K) | 提示词里写“4K”不会改变输出尺寸,默认出 1K | API 里设 image_size,取值 "1K" "2K" "4K",K 必须大写,小写会被拒绝 |
| 宽高比 | 可以写进提示词,但默认值不看提示词:编辑时跟随输入图,否则是 1:1 | API 里设 aspect_ratio,如 "16:9";聊天界面里把比例写在提示词末尾 |
| 一次出几张 | 模型不一定按你写的数量出图 | 同一条提示词多请求几次 |
| 参考图数量 | 超过模型的上限,保真度没有保证 | 按下一节的上限选模型,或减少参考图 |
| 最新信息(天气、赛果) | 模型不知道 | 打开“使用 Google 搜索建立依据”工具 |
| 图里的长段文字 | 一步到位容易出错 | 先让模型写出文字,再要求把文字放进图;带字的专业素材用 Nano Banana Pro |
| 水印 | 无法通过提示词改变 | 所有生成的图片都带 SynthID 水印 |
该用哪个模型
模型不同,同一条提示词能做到的事也不同。截至 2026 年 10 月 1 日,Gemini API 里有三个现行的图片模型:
| 模型 | Google 的定位 | 输出尺寸 | 参考图上限(总数不超过 14 张) |
|---|---|---|---|
| Nano Banana 2 Lite | 最快、最便宜;没有为多张参考图和多轮连续编辑做优化 | 只有 1K | 物体图最多 14 张 |
| Nano Banana 2 | 通用主力,Google 建议作为首选;4K、文字渲染、多参考图一致性 | 512px、1K、2K、4K | 物体图最多 10 张,角色图最多 4 张 |
| Nano Banana Pro | 最复杂的任务:专业素材、品牌一致性、复杂指令 | 1K、2K、4K | 物体图最多 6 张,角色图最多 5 张,风格参考图最多 3 张 |
选择规则很简单:
- 大量试方向、对速度和价格敏感,用 Nano Banana 2 Lite。
- 不确定用哪个,或者要多轮修改、多张参考图、4K,用 Nano Banana 2。
- 图上有品牌字样、要给客户交稿、指令又长又复杂,用 Nano Banana Pro。只有它支持单独的风格参考图。
各版本的来历和在 Gemini 应用里的入口,见 Nano Banana 是什么?版本、入口与用法。
最早的 Nano Banana(gemini-2.5-flash-image)已被标为弃用,Google 价格页给它定的停用日期是 2026 年 10 月 2 日。还在调用这个模型 ID 的旧代码要换掉,Google 建议迁到 Nano Banana 2 Lite(gemini-3.1-flash-lite-image)。
让出图更听话的六个做法
这六条来自 Google 提示词指南的“最佳实践”,前面的模板已经按它们写了,自己改写时照着做:
- 写得足够具体。 材质、颜色、形状、数量都写出来,写得越细,可控的越多。
- 说明用途。 模型会根据用途调整结果,“电商主图”和“公众号封面”得到的构图不一样。
- 小步修改。 第一张不满意就接着说“很好,把光线调暖一点”“其他都不变,把表情改得严肃一些”,一次只改一处。
- 复杂场景分步写。 “先画一片清晨起雾的森林做背景;再在前景加一座长满青苔的石台;最后在石台上放一盏发光的灯笼。”
- 用正面描述代替“不要 xx”。 想要没有车的街道,写“一条空旷安静的街道,路面上空无一物”,而不是“不要汽车”。
- 用摄影语言控制画面。 广角、微距、低角度仰拍、俯拍、浅景深,这些词直接决定构图。
第五条最容易被忽略。检查一下自己的提示词:每一句“不要……”都试着改成“画面里只有……”“背景是纯色的……”这样的正面说法。
把提示词放进 API
下面是 Google 文档给出的 Interactions API 写法(Python)。重点在分工:画面内容写在 input 里,尺寸和比例写在 response_format 里。
hljs pythonfrom google import genai
import base64
client = genai.Client()
prompt = """
生成一张用于笔记 App 官网首屏的图片。
主体是一台平板电脑,屏幕上是干净的笔记界面,位于画面右侧三分之一处。
场景是浅色木质书桌,上午的自然光从左侧照进来。
整体是明亮克制的写实摄影。左侧留出干净的空白。
"""
interaction = client.interactions.create(
model="gemini-3.1-flash-image",
input=prompt,
response_format={
"type": "image",
"aspect_ratio": "16:9",
"image_size": "2K",
},
)
with open("hero.png", "wb") as f:
f.write(base64.b64decode(interaction.output_image.data))
编辑图片时,input 换成一个列表,文字和图片各占一项:
hljs pythonwith open("sofa.png", "rb") as f:
image_bytes = f.read()
interaction = client.interactions.create(
model="gemini-3.1-flash-image",
input=[
{"type": "text", "text": "使用这张客厅的图片,只把蓝色沙发改成一张复古的棕色皮质沙发。房间的其余部分完全保持原样。"},
{"type": "image", "data": base64.b64encode(image_bytes).decode("utf-8"), "mime_type": "image/png"},
],
)
多轮修改不用重新上传图片,把上一次的 interaction.id 传给 previous_interaction_id 即可。Google 把多轮对话称为迭代图片的推荐方式:
hljs pythoninteraction_2 = client.interactions.create(
model="gemini-3.1-flash-image",
input="其他都不变,把光线调暖一点。",
previous_interaction_id=interaction.id,
response_format={"type": "image", "aspect_ratio": "16:9", "image_size": "2K"},
)
另外两点:
- Gemini 3 系列的图片模型默认会先“思考”再出图,这一步不能关闭。Nano Banana 2 和 Nano Banana 2 Lite 可以用
generation_config={"thinking_level": "high"}把思考程度从默认的minimal调到high,思考消耗的 token 会计费。 - 批量出图时如果收到 429,限额是按项目计算的,排查方法见 Gemini API 429:RPM、TPM、RPD 哪个超了。
每张图多少钱
以下是 Gemini API 折算到每张图的价格,单位美元,截至 2026 年 10 月 1 日,出自 Google 价格页。三个模型都没有免费层,详见 Gemini API 免费额度与限制:哪些模型免费,超限怎么办。
| 模型与尺寸 | 标准价(每张) | Batch 价(每张) |
|---|---|---|
| Nano Banana 2 Lite,1K | $0.0336 | $0.0168 |
| Nano Banana 2,512px | $0.045 | $0.022 |
| Nano Banana 2,1K | $0.067 | $0.034 |
| Nano Banana 2,2K | $0.101 | $0.050 |
| Nano Banana 2,4K | $0.151 | $0.076 |
| Nano Banana Pro,1K 或 2K | $0.134 | $0.067 |
| Nano Banana Pro,4K | $0.24 | $0.12 |
Batch 是异步批量接口,结果最长 24 小时内返回,适合不赶时间的大批量任务。
先用便宜的模型试方向、定稿再升档,差别很明显。假设试 20 张草图、最后交 1 张 4K:
- 20 张 Nano Banana 2 Lite 草图:20 × $0.0336 = $0.672
- 1 张 Nano Banana Pro 4K 定稿:$0.24
- 合计 $0.912
如果 20 张草图全用 Nano Banana Pro 4K,就是 20 × $0.24 = $4.80。
不想自己建 API 项目,也可以在 YingTu 按张付费使用同名模型:Nano Banana 2 在线生图每张 $0.055,Nano Banana Pro 在线生图每张 $0.09(截至 2026 年 9 月 26 日)。用的是你自己的 LaoZhang API key,请求走 LaoZhang 的接口,不是 Google 的 Gemini 应用。
出图不对,先改哪里
| 现象 | 多半是因为 | 先改这里 |
|---|---|---|
| 只回了一段文字,没有图 | 没说明要图片 | 以“生成一张……的图片”开头 |
| 构图不适合要用的地方 | 只写了主体,没写用途 | 加上用途和留白位置 |
| 该没有的东西还是出现了 | 用了“不要 xx” | 改成正面描述:“画面里只有……” |
| 图里的字错了或糊了 | 文字和画面一步生成 | 先生成文字再放进图;换 Nano Banana Pro;字多就留白后期排版 |
| 改图时不该变的地方变了 | 没写要保留什么 | 加一句“其余部分完全保持原样”,并把要保留的细节逐项写出 |
| 同一个角色越改越不像 | 没把之前的图传回去 | 每次带上之前生成的图,一次只换一个角度或动作 |
| 风格飘忽 | 风格词堆得太多 | 只留一个主风格,加一两个具体特征 |
| 写了 4K,下载下来不是 | 尺寸不归提示词管 | 设 image_size: "4K",并确认模型支持 |
| 数量不对 | 模型不保证张数 | 分多次请求 |
| API 报参数错误 | image_size 写成了小写 | 改成大写 "2K" "4K" |
常见问题
Gemini 生图用中文提示词可以吗,还是要翻成英文?
可以直接用中文。Google 的图片生成文档列出了效果最好的语言,zh-CN 在其中,和英文、日文、韩文并列。文档没有说哪种语言更准,所以用你最能把细节讲清楚的语言写;图上要出现中文时,把原文放在引号里。
提示词里写了 4K,为什么出来的不是 4K?
因为输出尺寸由参数决定。Gemini API 默认输出 1K,要在 response_format 里设 image_size: "4K"(K 大写),而且模型要支持:截至 2026 年 10 月 1 日,Nano Banana 2 和 Nano Banana Pro 支持 4K,Nano Banana 2 Lite 只有 1K。
图里的中文字怎么写才不容易出错?
三件事一起做:把要出现的文字原样放进引号;用描述的方式说明字体(“粗黑体”“手写毛笔字”);字多的时候先让模型把文字生成出来,再要求把这段文字放进图。Google 建议专业级的带字素材用 Nano Banana Pro。字很小、很密的排版,留白后用设计软件加字更稳妥。
怎么让同一个角色在多张图里保持一致?
把之前生成的图片作为参考图传回去,每次只改一个角度或动作,并在提示词里逐项写出要保持的特征。能保持一致的角色数量有上限:Nano Banana 2 最多 4 个,Nano Banana Pro 最多 5 个(截至 2026 年 10 月 1 日)。
一次能给 Gemini 几张参考图?
总数最多 14 张,细分上限按模型不同(截至 2026 年 10 月 1 日):Nano Banana 2 是物体图最多 10 张加角色图最多 4 张;Nano Banana Pro 是物体图最多 6 张、角色图最多 5 张、风格参考图最多 3 张;Nano Banana 2 Lite 可以放最多 14 张物体图,但 Google 说明它没有为多张参考图做优化。