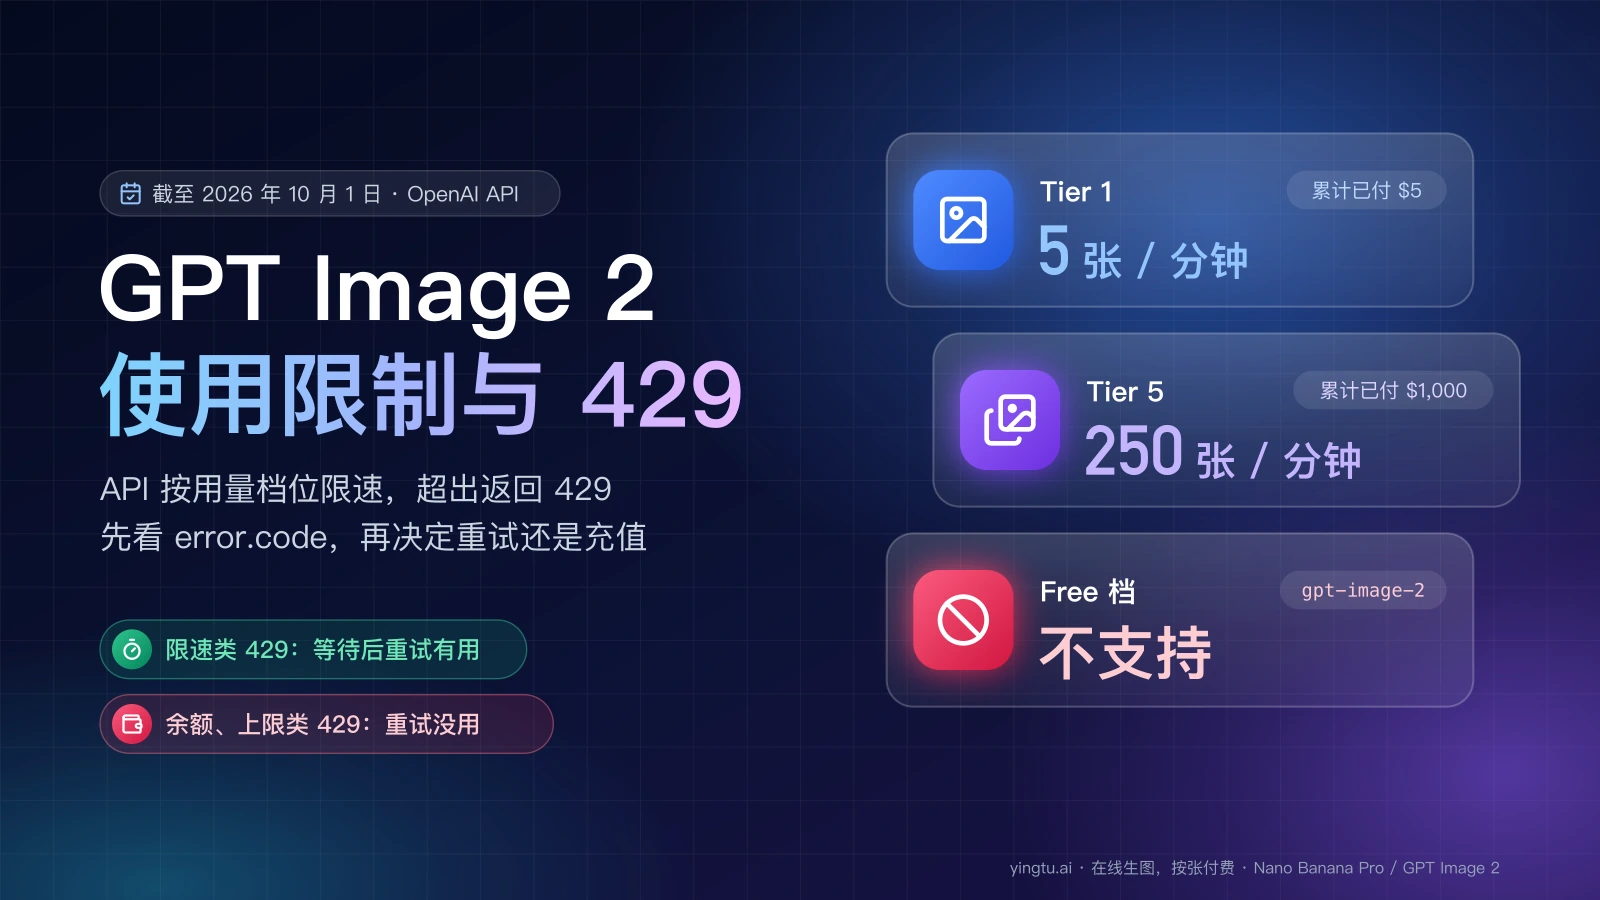
GPT Image 2 的使用限制是 OpenAI 按“用量档位”给每个组织分配的每分钟额度:截至 2026 年 10 月 1 日,gpt-image-2 在 API 里 Tier 1 每分钟最多 5 张图,Tier 5 每分钟最多 250 张,免费档不支持这个模型。超出后接口返回 HTTP 429。不过 429 并不都是“发得太快”,预付余额用完、你自己设的花费上限到了、OpenAI 给组织批的月度用量到了,返回的同样是 429,这几种情况等多久、重试多少次都不会恢复。区分它们靠响应体里的 error.code。
如果你是在 ChatGPT 应用里看到 "No image generation quota is currently available." 或 "You've hit the free plan limit for image generations requests.",那是 ChatGPT 套餐的生图额度,和下面的 API 档位无关,直接看ChatGPT 生图限制:各套餐额度与到限提示怎么处理。
gpt-image-2 各档位的每分钟上限
OpenAI 模型页列出的 gpt-image-2(快照 gpt-image-2-2026-04-21)速率限制如下。TPM 是每分钟 token 数,IPM 是每分钟图片数,两项里哪一项先用完,哪一项就触发 429。
| 用量档位(OpenAI API,截至 2026 年 10 月 1 日) | TPM(每分钟 token 数) | IPM(每分钟图片数) |
|---|---|---|
| Free | 不支持 | 不支持 |
| Tier 1 | 100,000 | 5 |
| Tier 2 | 250,000 | 20 |
| Tier 3 | 800,000 | 50 |
| Tier 4 | 3,000,000 | 150 |
| Tier 5 | 8,000,000 | 250 |
这张表适用于 v1/images/generations、v1/images/edits 和 Responses 接口的同步调用。按 IPM 粗算,Tier 1 一小时最多 5 × 60 = 300 张,Tier 2 是 20 × 60 = 1,200 张,前提是 TPM 没有先用完,而且请求分布均匀。
读这张表要注意两点。第一,限制按组织和项目计算,不按用户计算,同一个项目下的几个脚本共用一份额度。第二,部分模型家族共用一份额度,控制台 Limits 页会标注 shared limit。你的组织实际拿到的数字可能和公开表格不同,以控制台 Limits 页上 gpt-image-2 那一行为准。
GPT Image 2.5 方面,gpt-image-2.5-flare 的模型页列的是同一张分档表(截至 2026 年 9 月 30 日)。
按报错代码判断下一步
OpenAI 的错误代码说明要求账单类错误看 error.code,因为更宽的 error.type 仍可能统一显示为 insufficient_quota。下表按代码给出处理方向,适用于直连 OpenAI API,截至 2026 年 10 月 1 日。
| HTTP 状态与代码 | 属于哪一类 | 重试有没有用 | 去哪里处理 |
|---|---|---|---|
| 429 "Rate limit reached for requests" | 每分钟额度用完 | 有用,等够时间再发 | 按 Retry-After 等待,降低并发 |
429 slow_down | 流量涨得太快 | 有用,先降速再慢慢加 | 减小并发,分阶段加量 |
429 credit_balance_exhausted | 预付余额用完 | 没用 | 控制台 Billing 充值 |
429 organization_spend_limit_exceeded | 你给组织设的硬性花费上限到了 | 没用 | 组织设置里调高上限 |
429 project_spend_limit_exceeded | 你给项目设的硬性花费上限到了 | 没用 | 项目设置里调高上限 |
429 organization_usage_limit_exceeded | OpenAI 批给组织的月度用量到了 | 没用 | 申请更高的月度上限或联系支持 |
503 server_is_overloaded | 模型暂时过载,与你的额度无关 | 有用 | 按 Retry-After 等待后重试 |
| 403 地区不支持,或访问资格、验证类拒绝 | 不是限流 | 没用 | 解决访问资格问题 |
官方的原话是 "Retrying billing, spend, or quota errors won't restore API access.",余额、花费上限和月度用量这四个代码都在此列。
如果你用的是较旧的 SDK 或经过第三方网关,响应里可能只有 insufficient_quota 或 rate_limit_exceeded 两种写法。前者按“余额或上限”处理,去 Billing 和 Limits 页逐项排查;后者按“每分钟额度”处理。
"Rate limit reached for requests" 和 slow_down:等待后重试
这两种 429 是真正的限速,等待之后请求可以成功。
"Rate limit reached for requests" 表示某一项每分钟额度已经用完。对 Tier 1 来说,一分钟内发出第 6 张图的请求就会碰到它。处理办法是把请求排队,按档位的 IPM 控制发送节奏,而不是并发全部发出再靠重试补救。
slow_down 的触发条件不同:它看的是流量增长的速度,即使每分钟请求数和 token 数都在额度以内也可能出现。OpenAI 给的经验值是输入超过每分钟 100 万 token 之后,每 15 分钟加量不超过 50%。批量任务启动时从低并发开始,逐步提高,比一开始就开满更不容易碰到它。
重试时按 速率限制指南的做法:
- 响应带
Retry-After时,把它当作最少等待秒数,再加一小段随机延迟。 - 没有
Retry-After时,用指数退避加随机抖动。 - 给重试次数和总耗时都设上限。
- 失败的请求同样计入每分钟额度,连续重发只会让窗口一直是满的。
- 官方 SDK 会自动重试符合条件的 429 和 503。自己再写一层重试时,要么关掉 SDK 的重试,要么把两层的次数乘起来估算。
响应头里可以读到当前余量:x-ratelimit-limit-requests、x-ratelimit-remaining-requests、x-ratelimit-reset-requests,以及对应的 -tokens 版本和项目级的 x-ratelimit-remaining-project-tokens 等。官方的响应头表里没有按图片张数计数的字段,IPM 的余量看不到,只能自己按发出的张数记账。
下面是一段区分两类代码的 Python 示例,基于 openai SDK,未经运行验证,接入前请在自己的项目里测试。
hljs pythonimport random
import time
from openai import OpenAI, RateLimitError, InternalServerError
# 关掉 SDK 自带的重试,避免和下面的循环叠加
client = OpenAI(max_retries=0)
# 这些代码需要你去充值或调上限,重试不会恢复
NO_RETRY = {
"credit_balance_exhausted",
"organization_spend_limit_exceeded",
"project_spend_limit_exceeded",
"organization_usage_limit_exceeded",
"insufficient_quota",
}
def wait_seconds(err, attempt):
retry_after = err.response.headers.get("retry-after")
if retry_after:
base = float(retry_after)
else:
base = min(2 ** attempt, 60)
return base + random.uniform(0, 1)
def generate(prompt, max_attempts=5):
for attempt in range(max_attempts):
try:
return client.images.generate(
model="gpt-image-2",
prompt=prompt,
size="1024x1024",
)
except RateLimitError as err:
if err.code in NO_RETRY or err.type == "insufficient_quota":
raise # 余额或上限问题,交给人处理
time.sleep(wait_seconds(err, attempt))
except InternalServerError as err:
if err.code != "server_is_overloaded":
raise
time.sleep(wait_seconds(err, attempt))
raise RuntimeError("重试次数用完,仍被限速")
credit_balance_exhausted:预付余额用完,充值才能恢复
credit_balance_exhausted 表示组织的预付余额为零,和发送速度无关。官方给的处理办法只有一个:到控制台 Billing 页充值。
充值还会影响档位。OpenAI 按累计付款自动升档,每一档对应一个月度用量上限(截至 2026 年 10 月 1 日):
| 用量档位 | 升档条件(累计付款) | OpenAI 批准的月度用量上限 |
|---|---|---|
| Free | 位于支持的地区 | $100 / 月 |
| Tier 1 | 已付 $5 | $100 / 月 |
| Tier 2 | 已付 $50 | $500 / 月 |
| Tier 3 | 已付 $100 | $1,000 / 月 |
| Tier 4 | 已付 $250 | $5,000 / 月 |
| Tier 5 | 已付 $1,000 | $200,000 / 月 |
升档是自动的,官方的说法是 "As your spend on our API goes up, we automatically graduate you to the next usage tier."。想从每分钟 5 张提到 20 张,条件是累计付款达到 $50 并等系统升档,当前所在档位在控制台 Limits 页可以看到。Free 档虽然有月度用量上限,但 gpt-image-2 在这一档不可用,至少要到 Tier 1。
每张图要花多少、余额能撑多少张,见GPT Image 2 价格:一张图多少钱,账单怎么算。
organization_spend_limit_exceeded 和 project_spend_limit_exceeded:你自己设的花费上限
这两个代码表示触发的是你或管理员在控制台里配置的硬性花费上限,分别作用于整个组织和单个项目。
OpenAI 的花费控制有两种。花费提醒(Spend alert)只发通知,API 调用照常进行。硬性花费上限(Hard spend limit)到达后,受影响的请求直接返回 429。所以看到这两个代码时,余额可能还很充足,每分钟额度也没用完,只是有人设过一个数字。
处理办法是找到有权限的管理员,在组织或项目的限额设置里调高这个数字,或者确认这笔预算确实不该再花。
organization_usage_limit_exceeded:OpenAI 批的月度用量到了
organization_usage_limit_exceeded 表示组织当月用量达到了 OpenAI 批准的上限,也就是上面档位表的第三列。它和你自己设的花费上限是两项独立的限制,在控制台里改不了。
恢复的途径有两个:申请更高的月度上限或联系支持,或者通过累计付款升到下一档。Tier 1 和 Tier 2 的月度上限分别只有 $100 和 $500,上线前先按预计出图量算一遍月度花费,再决定要不要提前升档。
月度额度还没用完却收到 429,原因通常在这里:月度用量和每分钟额度各算各的。月度还有余量时,每分钟的 IPM 或 TPM 照样会先用完,这时的代码是限速类的,等待即可。
503 server_is_overloaded 与访问类拒绝
503 server_is_overloaded 是模型暂时过载,类型为 service_unavailable_error,不消耗也不反映你的额度。响应可能带 Retry-After,按它等待后重试即可,在 Python SDK 里它抛出的是 InternalServerError。
403 的地区不支持,以及因访问资格或组织验证被拒绝的请求,都不属于限流。OpenAI 可能要求组织先完成验证才能使用某些模型或功能,这类拒绝等待和降速都不会消除,需要解决资格本身。
Batch 接口和同步限制分开计算
Batch API 不占用同步调用的每分钟额度。它有自己的排队上限,按每个模型排队中的输入 token 数计算。不需要实时出图的批量任务放到 Batch,可以把同步额度留给线上请求。
Azure 上的 gpt-image-2 按请求数计,数字不同
Azure OpenAI(Microsoft Foundry)的配额由微软分配,单位是每分钟请求数(RPM),和 OpenAI 直连的 TPM / IPM 互不通用。微软配额文档(页面日期 2026 年 8 月 20 日)列出的数字如下。
| Azure 档位 | gpt-image-2 Global Standard | gpt-image-2 Data Zone Standard | gpt-image-2.5-flare / -sunburst Global Standard |
|---|---|---|---|
| Tier 1 | 6 RPM | 2 RPM | 5 RPM |
| Tier 2 | 12 RPM | 4 RPM | 5 RPM |
| Tier 3 | 18 RPM | 6 RPM | 5 RPM |
| Tier 4 | 24 RPM | 8 RPM | 5 RPM |
| Tier 5 | 30 RPM | 10 RPM | 5 RPM |
Azure 一共有七档(Free 和 Tier 1 到 6),随用量自动升档,额外配额通过配额申请表提交。需要留意的是共用范围:微软在 2026 年 5 月 7 日之后开始按订阅统一管理配额,先从部分模型做起,并说明很快会覆盖所有模型。按这种方式,同一订阅下,同一模型同一版本的 Global Standard 部署跨所有区域共用一份配额,在另一个区域再建一个部署不会多出额度;Data Zone Standard 则是每个数据区域一份。
第三方网关返回的 429 是网关自己的
通过中转或聚合网关调用时,429 多半来自网关自己的账号池或分组额度,和你在 OpenAI 的档位没有关系。2026 年 4 月就有网关发过公告,说明其共享的 gpt-image-2 资源紧张时会返回 429 和 408。这种情况下 OpenAI 控制台里查不到任何记录,该看的是网关的余额、分组和状态页,该问的是网关的客服。
反过来也成立:在第三方平台充值不会提高你的 OpenAI 档位。例如 YingTu 上的 GPT Image 2 在线生图按张计费,$0.03 一张(截至 2026 年 10 月 1 日),用你自己的 LaoZhang API key 调用,走的是另一套额度,适合不想先累计付款升档、只想按张付费出图的情况;它没有公布每分钟张数。
常见问题
GPT Image 2 的 API 限制是每天重置吗?
不是按天。gpt-image-2 的 TPM 和 IPM 都是每分钟额度,窗口过去后自动恢复,具体多久可以看响应头 x-ratelimit-reset-requests 和 x-ratelimit-reset-tokens。OpenAI 批准的用量上限按月计算,不会每天清零;你自己设的硬性花费上限要在控制台调高才会放行。
Tier 1 每分钟 5 张不够用,怎么提高?
累计付款达到 $50 后 OpenAI 会自动把组织升到 Tier 2,gpt-image-2 的上限变为每分钟 20 张(截至 2026 年 10 月 1 日)。在此之前,可以把不急的任务放到 Batch 接口,它不占同步额度。
ChatGPT Plus 会员能提高 API 的限制吗?
不能。ChatGPT 订阅和 API 分开计费,Plus 的说明里写明 "API usage is separate and billed independently"。API 档位只看 API 账户的累计付款。同样,API 也不是用来绕开 ChatGPT 应用内额度的办法,OpenAI 的条款禁止规避速率限制。
Azure 上 gpt-image-2 的限制和 OpenAI 一样吗?
不一样。Azure 按每分钟请求数分配配额,gpt-image-2 的 Global Standard 部署在 Tier 1 是 6 RPM、Tier 5 是 30 RPM(微软配额文档,页面日期 2026 年 8 月 20 日),由微软按订阅管理;OpenAI 直连按 TPM 和 IPM 计算,由 OpenAI 按组织管理。两边的档位互不影响。