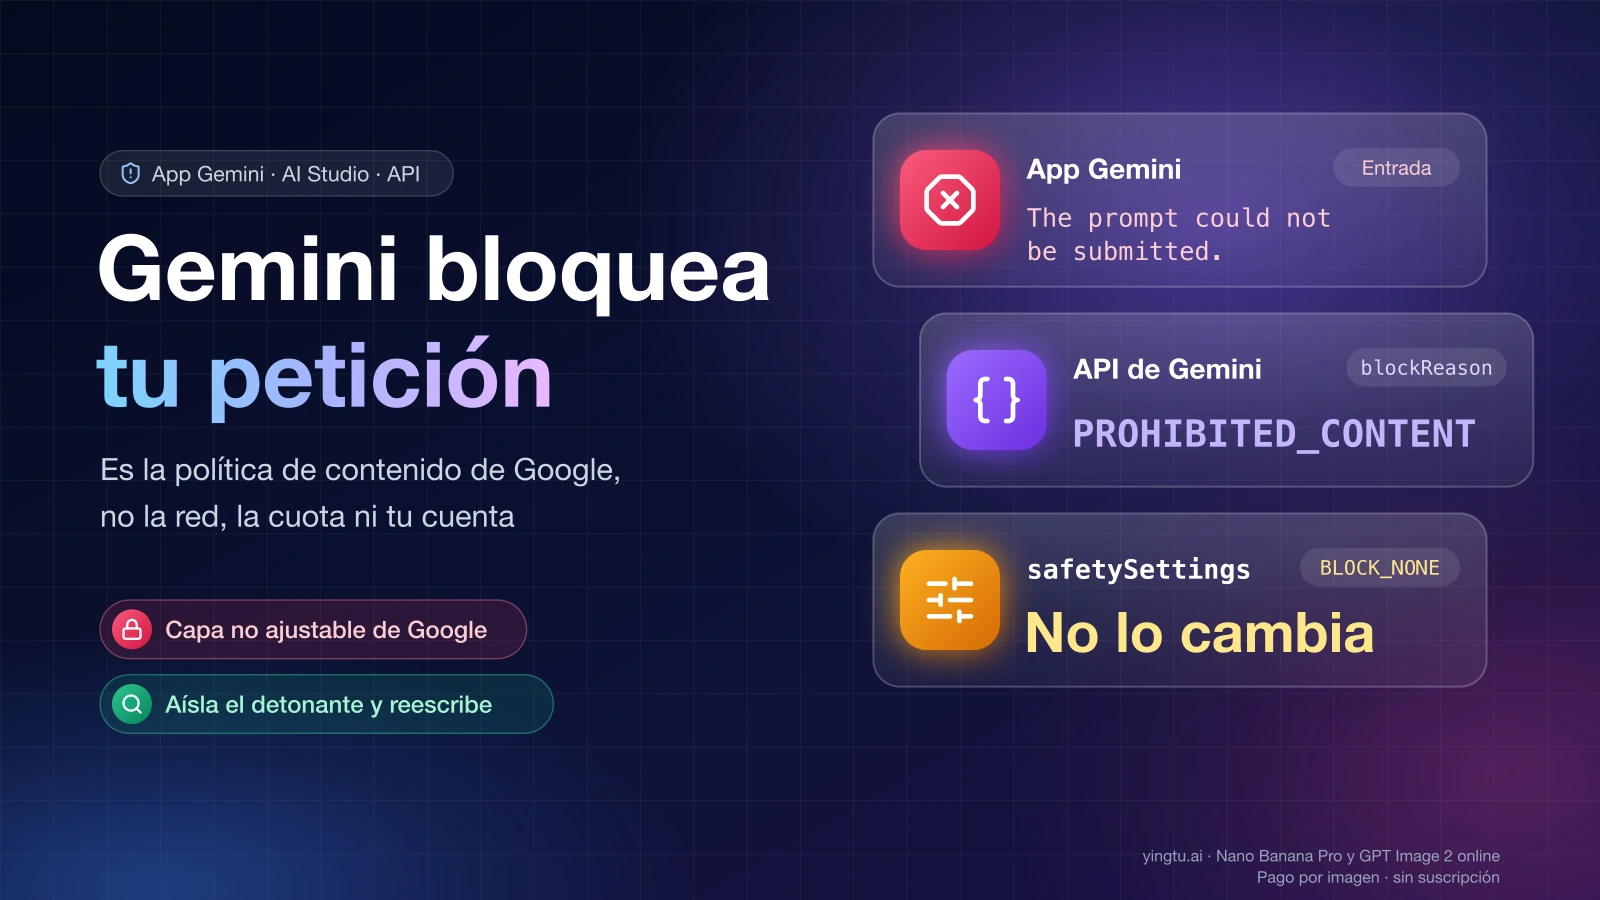
«The prompt could not be submitted. The prompt contains sensitive words that violate Google's Generative AI Prohibited Use Policy. Try rephrasing the prompt. If you think this was an error, send feedback.» es un bloqueo por la política de contenido de Google: el filtro que revisa cada petición (prompt) antes de que llegue al modelo ha decidido que el conjunto —tu texto, la imagen que adjuntas y el historial de la conversación— encaja en algo que la Política de Usos Prohibidos de la IA Generativa no permite. No es un fallo de red, de cuota, de región ni de tu cuenta: la misma clave y el mismo modelo responden a otra petición un segundo después.
El mismo bloqueo tiene tres caras según dónde trabajes. En la aplicación Gemini y en Google AI Studio aparece como texto en pantalla; la versión que los usuarios copian y pegan es la inglesa citada arriba. En la API de Gemini llega como promptFeedback.blockReason: "PROHIBITED_CONTENT" con esa misma frase en blockReasonMessage, o, si usas el SDK google-genai, como un error HTTP 400 invalid_request cuyo mensaje empieza por «Input blocked: The prompt could not be submitted…». Si lo que se bloquea no es tu petición sino la respuesta del modelo, el texto cambia a «The model output could not be generated…» y el código a finishReason: PROHIBITED_CONTENT. Las apps de terceros construidas sobre la API (chats con personajes, herramientas de escritura, agentes de programación) muestran el texto que su desarrollador decida enseñar, a veces el original y a veces uno propio.
Dos cosas cambian lo que puedes hacer. Primera: «sensitive words» no es una lista de palabras; es un clasificador que evalúa la petición completa, así que cambiar un término por un sinónimo casi nunca la desbloquea, y añadir una imagen o un historial largo puede bloquear un texto que solo funcionaba. Segunda: hay dos capas de filtro. La capa ajustable (SAFETY, cuatro categorías con umbral) responde a la configuración de seguridad de la API; la capa no ajustable (PROHIBITED_CONTENT, BLOCKLIST, las protecciones integradas como la seguridad infantil) no responde a ningún parámetro. Y si tu petición está dentro de lo que la política prohíbe (contenido sexual explícito, menores, personas reales en escenas íntimas o violentas), el bloqueo es correcto y la propia política prohíbe intentar rodearlo; el diagnóstico y los pasos que siguen sirven para el caso contrario, cuando la petición es legítima y aun así se bloquea.
Árbol de diagnóstico: de la pantalla al siguiente paso
Localiza tu caso en la fila que coincide con lo que ves. Los significados de los códigos son las frases de la documentación de la API de Gemini y del SDK google-genai, a 30 de septiembre de 2026.
| Dónde lo ves | Texto o código | Qué se bloqueó | ¿Lo cambia la configuración de seguridad? | Siguiente paso |
|---|---|---|---|---|
| Aplicación Gemini, Google AI Studio | «The prompt could not be submitted…» | Tu petición, antes de llegar al modelo | No | Aislar el detonante (petición mínima, prueba de 4 combinaciones si hay imagen) y reescribir hacia el resultado que buscas |
| Aplicación Gemini, Google AI Studio | «The model output could not be generated…» | La respuesta generada, no tu petición | No | Concretar el resultado que quieres; en imágenes con personas, indicar que son adultas y qué escena es |
| API, respuesta JSON | promptFeedback.blockReason: PROHIBITED_CONTENT o BLOCKLIST | Tu petición; no hay candidates | No | Registrar el texto final enviado y aislar; el enlace de comentarios del mensaje |
| API, SDK | HTTP 400 invalid_request, «Input blocked: …» | Tu petición | No | Igual que la fila anterior; no es un problema de acceso al modelo ni de facturación |
| API, respuesta JSON | promptFeedback.blockReason: SAFETY | Tu petición, por una de las 4 categorías ajustables | Sí | Fijar umbrales explícitos y leer safetyRatings |
| API, respuesta JSON | candidates[0].finishReason: SAFETY | La respuesta, por una categoría ajustable | Sí | Igual; en streaming el contenido llega vacío |
| API, respuesta JSON | finishReason: PROHIBITED_CONTENT, IMAGE_PROHIBITED_CONTENT, IMAGE_SAFETY, NO_IMAGE | La respuesta o la imagen generada | No | Cambiar la petición o la imagen de entrada, no los parámetros |
| Herramientas de programación, texto que reportan usuarios | «This request was blocked by Gemini's filters…» | Tu petición, con aviso de falso positivo probable | No | Reformular el fragmento técnico; enviar comentarios |
| Imagen en Vertex AI, no la API de Gemini | «…violate Google's Responsible AI practices» + código de soporte | Petición o imagen | Parcial (filtros propios de Vertex) | Consultar la categoría por el código de soporte de Imagen |
La última fila importa porque el mensaje es casi idéntico: si tu texto dice «Responsible AI practices» en vez de «Generative AI Prohibited Use Policy», estás en Imagen de Vertex AI, que tiene su propia configuración de filtros y códigos de soporte, y nada de lo que sigue sobre blockReason se aplica igual.
«The prompt could not be submitted. The prompt contains sensitive words that violate Google's Generative AI Prohibited Use Policy»
«The prompt could not be submitted. The prompt contains sensitive words that violate Google's Generative AI Prohibited Use Policy. Try rephrasing the prompt. If you think this was an error, send feedback.» significa que la petición se detuvo en la entrada: el modelo nunca la recibió, no hay respuesta parcial y, en la API, no hay candidatos que leer. A 30 de septiembre de 2026, la documentación de la API describe el código correspondiente, PROHIBITED_CONTENT, como «The prompt was blocked because it contains prohibited content» (la petición se bloqueó porque contiene contenido prohibido), y el SDK devuelve la frase completa en promptFeedback.blockReasonMessage.
Este bloqueo pertenece a la capa no ajustable. La página de configuración de seguridad de la API, actualizada el 17 de septiembre de 2026, lo dice así: «The Gemini API has built-in protections against core harms, such as content that endangers child safety. These types of harm are always blocked and cannot be adjusted» (la API de Gemini tiene protecciones integradas contra los daños principales, como el contenido que pone en peligro la seguridad infantil; estos daños se bloquean siempre y no se pueden ajustar). Por eso poner las cuatro categorías en BLOCK_NONE no cambia nada aquí: esos umbrales gobiernan otro código, SAFETY.
En la práctica, el detonante suele ser una combinación y no un término aislado. Algunas combinaciones que provocan este bloqueo con partes que por separado pasan: palabras de edad ambiguas («chica», «joven», «estudiante», «teen») junto a un contexto íntimo, violento o de ropa; una foto subida de una persona real más una instrucción de cambiarle la ropa, la postura o el cuerpo; instrucciones para algo ilegal aunque el marco sea ficción; datos personales de terceros; y material pegado (un chat, un fragmento de novela, un volcado de código con casos de prueba de seguridad) que contiene algo que, leído sin su contexto, encaja en la política. El punto de partida correcto no es reenviar con otra palabra, sino averiguar qué parte de la petición hace saltar el filtro; los pasos están más abajo.
«The model output could not be generated. This output contains sensitive words that violate Google's Generative AI Prohibited Use Policy»
«The model output could not be generated. This output contains sensitive words that violate Google's Generative AI Prohibited Use Policy. If you think this was an error, send feedback.» significa lo contrario del anterior: tu petición pasó, el modelo empezó a generar, y fue la respuesta —texto o imagen— la que el filtro de salida retiró. En la API se ve como candidates[0].finishReason: "PROHIBITED_CONTENT", con la misma frase en finishMessage; el SDK lo define, a 30 de septiembre de 2026, como «Token generation stopped for potentially containing prohibited content» (la generación se detuvo por contener posiblemente contenido prohibido).
Que el bloqueo caiga en la salida cambia la estrategia. La petición no describía nada prohibido, pero era lo bastante abierta para que el modelo la completara con algo que sí lo es. Con texto, eso pasa con instrucciones del tipo «continúa la escena» o «hazlo más intenso» sobre un historial que ya roza el límite; con imágenes, con peticiones que dejan sin fijar la edad, la ropa o la situación de las personas. La corrección consiste en cerrar esas variables tú, no en dejar que las cierre el modelo: di que las personas son adultas, describe la ropa y la escena concretas que quieres, y quita del historial lo que no hace falta para la tarea.
Un detalle operativo para quien lo lee en código: con SAFETY el SDK avisa de que «When streaming, content is empty if content filters blocks the output» (en streaming, el contenido llega vacío si los filtros bloquean la salida). No lo trates como un fallo de conexión ni como una respuesta vacía del modelo: lee finishReason del último fragmento antes de reintentar. Y en generación de imágenes con los modelos nativos de la API (gemini-3.1-flash-image, gemini-3-pro-image y sus variantes), los códigos equivalentes son IMAGE_PROHIBITED_CONTENT («Image generation stopped because the generated images have prohibited content»), IMAGE_SAFETY y NO_IMAGE («The model was expected to generate an image, but none was generated»), todos a 30 de septiembre de 2026 según el SDK.
PROHIBITED_CONTENT y los demás códigos de la API
PROHIBITED_CONTENT es el valor que la API de Gemini devuelve cuando el filtro no ajustable bloquea la petición (promptFeedback.blockReason) o la respuesta (finishReason); no está relacionado con la cuota ni con los permisos de la clave. Los demás valores se distinguen así. Las frases en inglés son las de la referencia de la API y del SDK google-genai; la columna de acción es la consecuencia práctica de que el código sea o no ajustable. Todo a 30 de septiembre de 2026.
| Código | Dónde aparece | Frase de Google | Qué significa para ti | ¿Ajustable? |
|---|---|---|---|---|
SAFETY | blockReason y finishReason | «The prompt was blocked for safety reasons.» / «Token generation stopped because the content potentially contains safety violations.» | Una de las cuatro categorías ajustables superó el umbral configurado; safetyRatings dice cuál | Sí |
PROHIBITED_CONTENT | blockReason y finishReason | «The prompt was blocked because it contains prohibited content.» / «Token generation stopped for potentially containing prohibited content.» | El clasificador de la política de usos prohibidos; los umbrales no intervienen | No |
BLOCKLIST | blockReason y finishReason | «…contains a term from the terminology blocklist.» / «…contains forbidden terms.» | Un término de la lista de términos bloqueados (blocklist) de Google, no publicada | No |
OTHER | blockReason | «…may be due to the prompt's language, or because it contains other harmful content.» | Idioma no admitido u otro motivo; la guía de resolución de problemas añade que puede contravenir las condiciones del servicio | No |
IMAGE_SAFETY | blockReason y finishReason | «…content that is unsafe for image generation.» / «…generated images have safety violations.» | La petición o la imagen generada no pasa el filtro de imágenes | No |
IMAGE_PROHIBITED_CONTENT | finishReason | «Image generation stopped because the generated images have prohibited content.» | La imagen generada cae en la política | No |
NO_IMAGE | finishReason | «The model was expected to generate an image, but none was generated.» | Se esperaba imagen y no llegó; suele acompañar a un filtrado silencioso | No |
SPII | finishReason | (información personal sensible) | La respuesta contenía datos personales identificables | No |
RECITATION | finishReason | (recitación) | La respuesta reproducía material protegido; la guía oficial pide hacer la petición «as unique as possible» y subir la temperatura | No es un filtro de contenido |
La página de códigos de error de la API, actualizada el 20 de septiembre de 2026, repite los mismos motivos en minúsculas dentro de la respuesta de error (safety, prohibited_content «Prohibited content guidelines blocked the request.», blocklist, image_safety, image_prohibited_content, no_image) y los separa de los códigos HTTP que sí son problemas de acceso: 400 invalid_request o failed_precondition, 429 rate_limit_exceeded. Si el error es 429, el problema es de cuota y no de contenido; si es 400 con «Input blocked», es este bloqueo, aunque la etiqueta invalid_request sugiera un error de formato.
«This request was blocked by Gemini's filters. They can occasionally trigger by mistake on safe coding, security, or biology-related queries»
«This request was blocked by Gemini's filters. They can occasionally trigger by mistake on safe coding, security, or biology-related queries. Please try rephrasing your prompt. You can send feedback or read more about our policies here.» es una variante del mismo bloqueo de entrada que los usuarios reportan en herramientas de programación con Gemini; la propia frase reconoce que el filtro se dispara por error con consultas legítimas de código, seguridad o biología. No hay documentación pública que asocie este texto a un producto concreto, así que conviene leerlo como lo que dice: el mismo filtro no ajustable, con un aviso explícito de falso positivo probable.
El caso documentado más claro es del 14 de septiembre de 2026 en el foro de desarrolladores de Google: un agente que ejecutaba gemini-3.8-flash a través de Antigravity recibió «The prompt could not be submitted…» al resumir una batería de pruebas que contenía «adversarial mutation testing», casos de inyección con <script> y la expresión «mutant killers». Nada de eso es ofensivo; leído por un clasificador, parece una instrucción de ataque. No hubo respuesta oficial en ese hilo, y la sugerencia de otro usuario de desactivar la configuración de seguridad no podía funcionar, porque el bloqueo no era SAFETY.
Para trabajo técnico, lo que sí funciona es separar el vocabulario de ataque del resto: manda el resumen de pruebas sin los payloads literales, describe los casos («caso 3: inyección de etiqueta script en el campo nombre») en vez de pegarlos, y mantén los payloads en tu repositorio, donde el modelo no tiene que leerlos para hacer la tarea. Si el fragmento técnico es imprescindible y sigue bloqueado, el enlace de comentarios del mensaje es el único canal que llega al equipo del filtro.
Qué puede cambiar la configuración de seguridad y qué no
La regla de decisión, a 30 de septiembre de 2026 según la página de configuración de seguridad de la API de Gemini, es esta: si el código es SAFETY, la configuración de seguridad decide; si el código es PROHIBITED_CONTENT, BLOCKLIST, IMAGE_SAFETY, IMAGE_PROHIBITED_CONTENT u OTHER, ningún parámetro de la petición lo cambia y solo cambia el contenido.
La capa ajustable tiene cuatro categorías: acoso (Harassment, «Negative or harmful comments targeting identity and/or protected attributes»), incitación al odio (Hate speech, «Content that is rude, disrespectful, or profane»), contenido sexual explícito (Sexually explicit, «Contains references to sexual acts or other lewd content») y contenido peligroso (Dangerous, «Promotes, facilitates, or encourages harmful acts»). Cada una admite cinco umbrales: OFF, BLOCK_NONE, BLOCK_ONLY_HIGH, BLOCK_MEDIUM_AND_ABOVE y BLOCK_LOW_AND_ABOVE, y cada respuesta trae en safetyRatings la probabilidad estimada por categoría: NEGLIGIBLE, LOW, MEDIUM o HIGH.
Hay una consecuencia que explica la mayoría de las confusiones: «If the threshold is not set, the default block threshold is Off for Gemini 2.5 and 3 models» (si no se fija el umbral, el umbral de bloqueo por defecto es Off para los modelos Gemini 2.5 y 3). Es decir, en los modelos actuales la capa ajustable ya no bloquea nada salvo que tú la actives. Si usas Gemini 2.5 o 3 sin tocar safetySettings y te bloquean, el bloqueo viene casi con seguridad de la capa no ajustable, y bajar umbrales que ya están en Off no puede ayudar. Fijarlos explícitamente sigue siendo buena práctica por otra razón: sabes qué filtras tú y qué filtra Google, y puedes leer el código correcto cuando algo falla.
Así se fijan y se leen los dos códigos con el SDK google-genai para Python:
hljs pythonfrom google import genai
from google.genai import errors, types
client = genai.Client() # lee GEMINI_API_KEY del entorno
config = types.GenerateContentConfig(
safety_settings=[
types.SafetySetting(
category=types.HarmCategory.HARM_CATEGORY_HARASSMENT,
threshold=types.HarmBlockThreshold.BLOCK_ONLY_HIGH,
),
types.SafetySetting(
category=types.HarmCategory.HARM_CATEGORY_HATE_SPEECH,
threshold=types.HarmBlockThreshold.BLOCK_ONLY_HIGH,
),
types.SafetySetting(
category=types.HarmCategory.HARM_CATEGORY_SEXUALLY_EXPLICIT,
threshold=types.HarmBlockThreshold.BLOCK_MEDIUM_AND_ABOVE,
),
types.SafetySetting(
category=types.HarmCategory.HARM_CATEGORY_DANGEROUS_CONTENT,
threshold=types.HarmBlockThreshold.BLOCK_ONLY_HIGH,
),
],
)
try:
response = client.models.generate_content(
model="gemini-2.5-flash",
contents=peticion, # el texto final, tal como se envía
config=config,
)
except errors.APIError as e:
# El bloqueo de entrada puede llegar como HTTP 400 "Input blocked: ..."
print("Error de la API:", e.code, e.message)
raise
feedback = response.prompt_feedback
if feedback is not None and feedback.block_reason:
# La petición no llegó al modelo: no hay candidatos que leer
print("Petición bloqueada:", feedback.block_reason, feedback.block_reason_message)
elif response.candidates:
candidato = response.candidates[0]
if candidato.finish_reason and candidato.finish_reason.name != "STOP":
# La respuesta se cortó; SAFETY trae safetyRatings, PROHIBITED_CONTENT no depende de los umbrales
print("Respuesta bloqueada:", candidato.finish_reason, candidato.safety_ratings)
else:
print(response.text)
Si tu código pasa por una pasarela o un servidor propio, registra tres cosas por separado en cada fallo: el texto final que se envió (después de plantillas, historial y mensaje de sistema), blockReason o finishReason, y safetyRatings cuando existan. Sin ese registro no puedes distinguir un falso positivo de un historial que arrastra algo que sí incumple la política.
Cómo aislar el detonante paso a paso
El objetivo es encontrar qué parte de la petición hace saltar el filtro y reescribir esa parte hacia el resultado que quieres, no probar sinónimos hasta que cuele. Los pasos, en orden:
-
Reproduce el bloqueo con la petición mínima. Quita el mensaje de sistema, el historial y los adjuntos, y envía solo la instrucción. Si pasa, el detonante está en lo que quitaste; si sigue bloqueada, está en la instrucción.
-
Devuelve los fragmentos de uno en uno. Primero el mensaje de sistema, luego el historial por bloques, luego los adjuntos. El primer fragmento que vuelve a provocar el bloqueo es el que hay que revisar. En una conversación larga suele ser un turno antiguo, no el último.
-
Si hay una imagen, haz la prueba de cuatro combinaciones: imagen original con la instrucción original, imagen original con una instrucción corta y neutra («describe esta imagen»), una imagen neutra (un paisaje, un objeto) con la instrucción original, y la imagen neutra con la instrucción corta. Si solo fallan las dos filas con la imagen original, la imagen es el detonante; si solo fallan las dos con la instrucción original, es el texto; si fallan tres, es la combinación de ambos.
-
Cuando la imagen es el detonante, mira qué buscan los filtros de imagen. La página de IA responsable de Imagen en Vertex AI, actualizada el 24 de septiembre de 2026, enumera sus categorías de filtrado: menores, famosos, «famoso o menor», personas y caras, información personal, contenido sexual, violencia, vulgaridad, odio, contenido peligroso, contenido de terceros y tóxico. Esa lista es de Imagen, no de la API de Gemini, pero describe bien lo que un filtro de imagen evalúa: una foto de alguien que parece menor, una cara reconocible o una persona real en ropa interior bloquean la edición aunque tu instrucción sea «cambia el fondo».
-
Reescribe hacia el resultado. Describe la escena final en lugar de la transformación («retrato de una mujer adulta con abrigo rojo en una calle nevada, luz de tarde») y evita las instrucciones sobre el cuerpo de una persona real. Si generas personas, di explícitamente que son adultas. Recuerda también la condición de la documentación de generación de imágenes, a 30 de septiembre de 2026: «Make sure you have the necessary rights to any images you upload» (asegúrate de tener los derechos necesarios sobre cualquier imagen que subas) y no generar contenido que engañe, acose o dañe a otros.
-
Si la petición legítima sigue bloqueada tras aislar y reescribir, usa el enlace «send feedback» del propio mensaje. Es el único canal que revisa el equipo del filtro; el foro de desarrolladores sirve para contrastar con otros casos, pero no cambia el clasificador.
-
Si en algún paso descubres que el detonante es precisamente lo que quieres obtener (una persona real desnuda, un menor en una situación sexual, violencia gráfica contra alguien identificable), para. El bloqueo es correcto y no hay una variante que lo evite: la política prohíbe expresamente eludir los filtros.
Falsos positivos documentados y qué se hizo en cada caso
Los falsos positivos existen; una de las variantes del mensaje que reportan los usuarios lo dice de forma explícita («They can occasionally trigger by mistake…»). Tres informes del foro de desarrolladores de Google, con fecha, muestran cómo se presentan y qué sirvió:
- 7 de julio de 2026: con el SDK
google-genaiy facturación activa, una petición agemini-omni-flash-previewdevolvía HTTP 400invalid_requestcon «Input blocked: The prompt could not be submitted…». El usuario creía que no tenía acceso al modelo. La respuesta de la comunidad del 8 de julio lo aclara: «that error means the safety filter is blocking your specific prompt content, not that youre ineligible for the model itself» (ese error significa que el filtro de seguridad bloquea el contenido concreto de tu petición, no que no puedas usar el modelo). Recomendó reformular, usar el enlace de comentarios y revisar si hay algo señalable «buried in a larger input» (enterrado en una entrada más grande). - 14 de septiembre de 2026: el caso de las pruebas de seguridad descrito más arriba (
gemini-3.8-flash, vocabulario de mutation testing e inyección). Sin respuesta oficial; la solución práctica es no enviar los payloads literales. - 13 de marzo de 2026: en Veo 3.1 (vídeo a partir de imagen, misma familia de políticas), un guion gráfico comercial inofensivo se bloqueaba como falso positivo de seguridad infantil, y el filtro siguió activándose después de quitar toda referencia a menores. Es otro producto, pero ilustra que un filtro de seguridad infantil puede seguir activándose sobre la imagen aunque el texto ya no mencione a menores.
Cuando has aislado el detonante, la petición es claramente legítima y la misma edición de imagen sigue fallando en Gemini, la salida razonable no es insistir en el mismo filtro sino lanzar la misma petición en otro modelo de imagen. En el generador de imágenes IA de YingTu puedes ejecutarla en el navegador con GPT Image 2 o Seedream pegando tu propia clave de la API de LaoZhang y pagando por imagen: a 26 de septiembre de 2026, GPT Image 2 VIP cuesta 0,03 $ por imagen y Nano Banana Pro 0,09 $ (ten en cuenta que Nano Banana Pro es el propio gemini-3-pro-image de Google, así que hereda el mismo filtro; el cambio de modelo real es GPT Image 2 o Seedream). Ese estudio hace su propia comprobación de salida y también rechaza el contenido que incumple la política, de modo que solo resuelve el caso del falso positivo, no el de una petición que Google rechazó con razón.
Si usas una app de terceros construida sobre Gemini
Si el mensaje te aparece en una app de chat con personajes, un asistente de escritura o cualquier servicio que no sea de Google, el bloqueo lo aplica la API de Gemini a la petición que la app envía, y esa petición incluye cosas que tú no ves: el perfil del personaje, las instrucciones de sistema de la app y el historial completo. Solo el desarrollador de la app puede leer blockReason y saber si el detonante está en tu último mensaje o en lo que la app añade.
Lo que sí está en tu mano: empezar una conversación nueva (el historial acumulado es un detonante frecuente), reescribir el último mensaje describiendo lo que quieres que pase en lugar de la palabra que crees que lo provocó, y no adjuntar fotos de personas reales en escenas íntimas. Lo que no está en tu mano: ningún ajuste de la app cambia la capa no ajustable, y el bloqueo no indica nada sobre tu cuenta de Google ni sobre la de la app; es una decisión por petición.
Si eres quien desarrolla la app, dos medidas evitan la mayor parte de los tickets: enseña al usuario un mensaje propio que diga que el contenido se ha bloqueado por la política de contenido de Google y qué puede cambiar (en vez de pasar el inglés literal), y registra en tu servidor el texto final más blockReason para cada bloqueo, porque el detonante suele estar en tu plantilla de sistema y no en el mensaje del usuario.
Dónde se detiene: lo que la política prohíbe
La política que cita el mensaje es la «Política de Usos Prohibidos de la IA Generativa» de Google, con última modificación el 17 de diciembre de 2024, y se aplica a la aplicación Gemini, a Google AI Studio y a la API de Gemini. Entre los usos que prohíbe, los que explican la mayoría de los bloqueos legítimos son, con su redacción en español: «Explotación o el abuso sexual infantil»; contenido que «facilite imágenes íntimas no consentidas»; «Contenido sexual explícito, como contenido creado con fines pornográficos»; y la cláusula que cierra cualquier intento de rodeo: «Elusión de las protecciones contra abusos o los filtros de seguridad (por ejemplo, manipular el modelo para infringir nuestras políticas)».
Esa última cláusula es la razón de que una lista de palabras sustitutas o una plantilla que «pase» no sean una salida: usarlas sería en sí un incumplimiento, y el clasificador evalúa la intención del conjunto, no los términos. La política también prevé excepciones («Podemos hacer algunas excepciones a estas políticas por motivos educativos, documentales, científicos o artísticos»), pero esas excepciones las aplica Google al valorar un caso, no las obtiene el usuario formulando la petición de otra manera. Si tu trabajo entra en una de ellas y el filtro lo bloquea, el camino es el enlace de comentarios con el contexto de la excepción, no una reformulación.
Preguntas frecuentes
¿Qué significa exactamente prohibited_content en la API de Gemini?
Que el filtro no ajustable de la política de usos prohibidos bloqueó la petición (si aparece en promptFeedback.blockReason) o la respuesta (si aparece en finishReason). La página de códigos de error lo define, a 30 de septiembre de 2026, como «Prohibited content guidelines blocked the request.». No tiene relación con la cuota, la clave ni la región, y safetySettings no lo modifica.
He puesto las cuatro categorías en BLOCK_NONE y sigue bloqueando. ¿Por qué?
Porque BLOCK_NONE solo actúa sobre el código SAFETY. Si el código que recibes es PROHIBITED_CONTENT, BLOCKLIST o IMAGE_SAFETY, estás en la capa integrada que la documentación describe como «always blocked and cannot be adjusted». Además, en Gemini 2.5 y 3 el umbral por defecto ya es Off, así que bajar umbrales no cambia nada respecto a no fijarlos.
La edición que pido es inofensiva («cambia el fondo») y aun así se bloquea. ¿Qué pasa?
Casi siempre el detonante es la imagen subida, no la instrucción: una cara reconocible, alguien que parece menor o una persona real con poca ropa hacen saltar el filtro de imagen con cualquier texto. La prueba de cuatro combinaciones del apartado de aislamiento lo confirma en dos minutos; si la imagen es el problema, usa una foto distinta o describe la escena completa en texto en lugar de editar esa foto.
¿El bloqueo significa que Google ha limitado mi cuenta o mi clave?
No. Es una decisión sobre esa petición concreta, y la misma clave sigue atendiendo las demás. La respuesta de la comunidad del 8 de julio de 2026 al informe del SDK lo resume: el filtro bloquea el contenido específico de la petición, no tu acceso al modelo. Si además ves errores 429 o 403, esos sí son problemas de cuota o permisos, pero son independientes de este mensaje.
¿Cómo distingo un bloqueo de entrada de uno de salida sin ver código?
Por el texto: «The prompt could not be submitted» es de entrada (tu petición no llegó al modelo), «The model output could not be generated» es de salida (la respuesta se generó y se retiró). En el primero hay que cambiar lo que envías; en el segundo, cerrar las variables que el modelo estaba rellenando por su cuenta (edad, ropa, escena, tono).